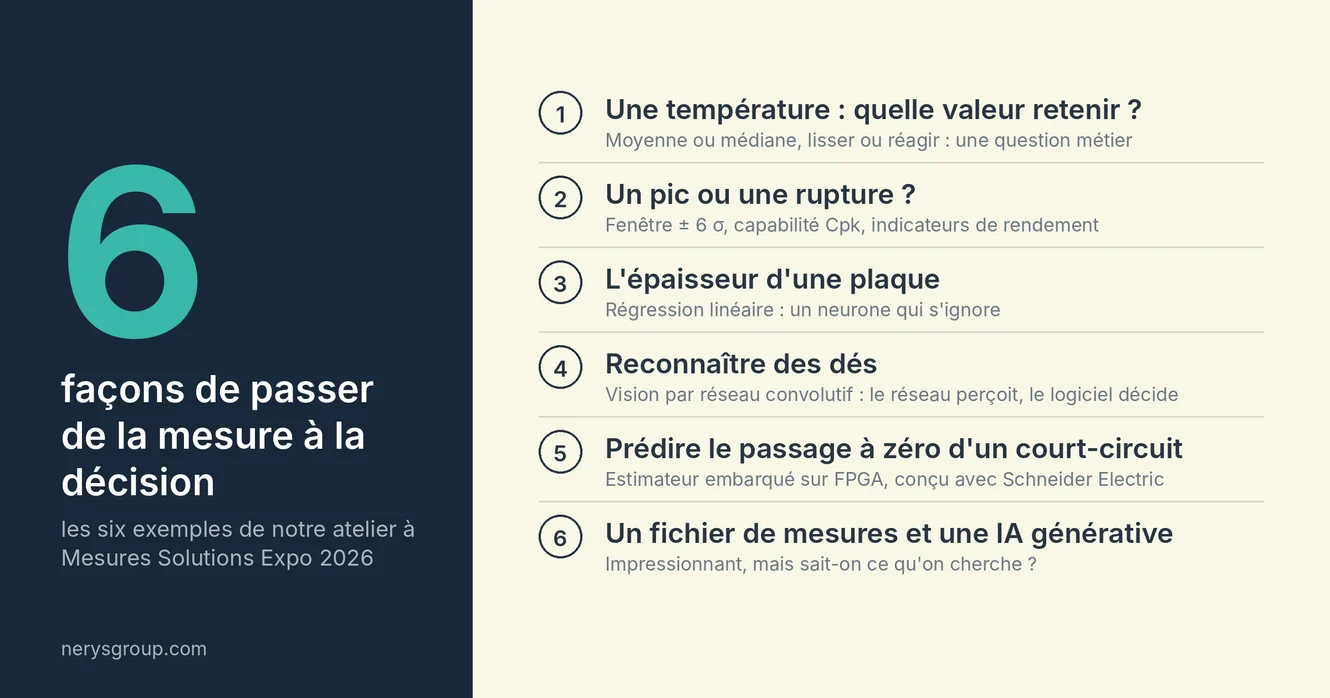
Trente minutes, six cas industriels et une seule question : comment passe-t-on d'une mesure à une décision ? À Mesures Solutions Expo, le chronomètre a obligé Luc Desruelle et Amaury Laurent à survoler. Voici la version longue, avec les chiffres, les courbes et les vidéos qu'ils avaient sous la main, et ce qu'ils ont choisi de ne pas montrer.
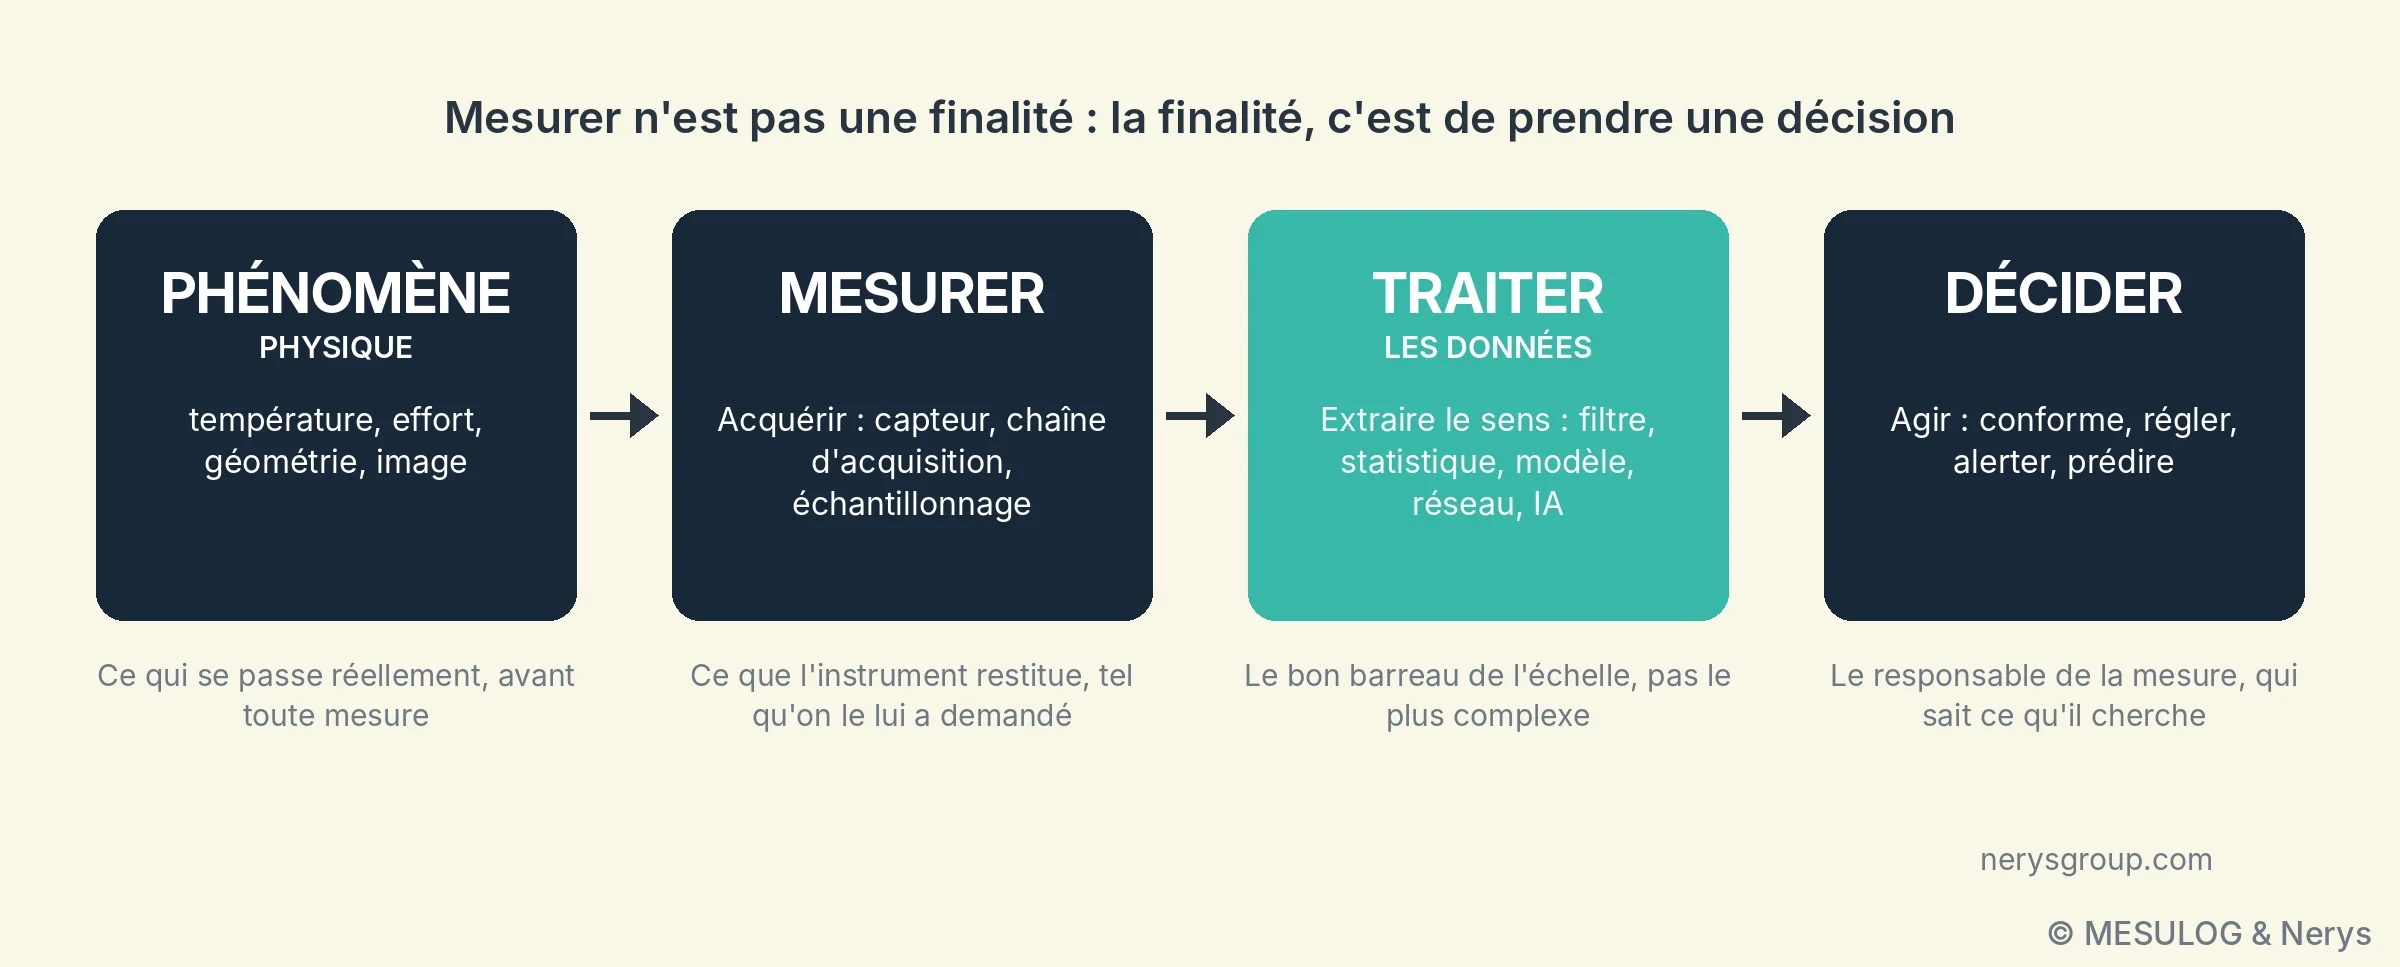
Mesurer n'est pas une finalité. Personne ne paie un banc d'essais pour obtenir des chiffres ; on le paie pour décider : conforme ou non, régler ou laisser, alerter ou attendre, et de plus en plus souvent, prédire. Entre la grandeur physique et cette décision, il y a un traitement. C'est lui qui fait la valeur de la mesure, et c'est lui qu'on choisit le plus souvent par habitude.
Le 15 octobre, à Lyon, Luc Desruelle, président de Mesulog et de Nerys, et Amaury Laurent, responsable des systèmes embarqués et de la R&D chez Nerys, ont déroulé six exemples tirés de leurs projets, du plus simple au plus pointu : une moyenne glissante, une capabilité de procédé, une régression linéaire sur un nuage de points, une caméra à réseau de neurones, un estimateur embarqué sur FPGA conçu avec Schneider Electric, et une IA générative à qui l'on confie un fichier de mesures. Le fil conducteur tenait en une phrase, répétée après chaque exemple : « ça a marché parce que nous savions ce que nous cherchions ». La fin de l'atelier montrait ce qui se passe quand ce n'est pas le cas.
1. Une température : quelle valeur retenir ?
Le cas le plus simple qui soit, monté pour l'occasion dans LabVIEW : la température de la salle de Mesures Solutions Expo, stable autour de 18 °C. Une mesure réelle n'est jamais parfaitement stable. Elle porte un bruit, et de temps en temps une valeur franchement aberrante : un parasite sur la liaison, un contact qui bouge, une perturbation électromagnétique au démarrage d'un moteur voisin.
Moyenne ou médiane : deux hypothèses sur le bruit
Premier réflexe : lisser par une moyenne glissante. Sur la démonstration, l'afficheur passe d'une mesure brute à 18,2 °C ± 3,7 °C à une valeur traitée à 18,7 °C ± 0,4 °C : le bruit est divisé par neuf, mais les pics ont décalé la valeur affichée d'un demi-degré. La moyenne lisse très bien le bruit, mais une seule valeur aberrante la tire vers elle. Avec une fenêtre de 25 points, un pic isolé à 50 °C décale la moyenne d'environ 1,3 °C, et il la décale pendant toute la durée où il reste dans la fenêtre, soit 25 échantillons. Sur la courbe, la moyenne « décroche » en marche d'escalier à chaque pic.
La médiane glissante, calculée sur la même fenêtre, ne bouge pas : un point aberrant sur 25 est rangé en bout de liste et n'influe pas sur la valeur centrale. Elle reste juste tant que la majorité des points de la fenêtre est saine, c'est-à-dire tant que les valeurs aberrantes restent minoritaires et isolées.
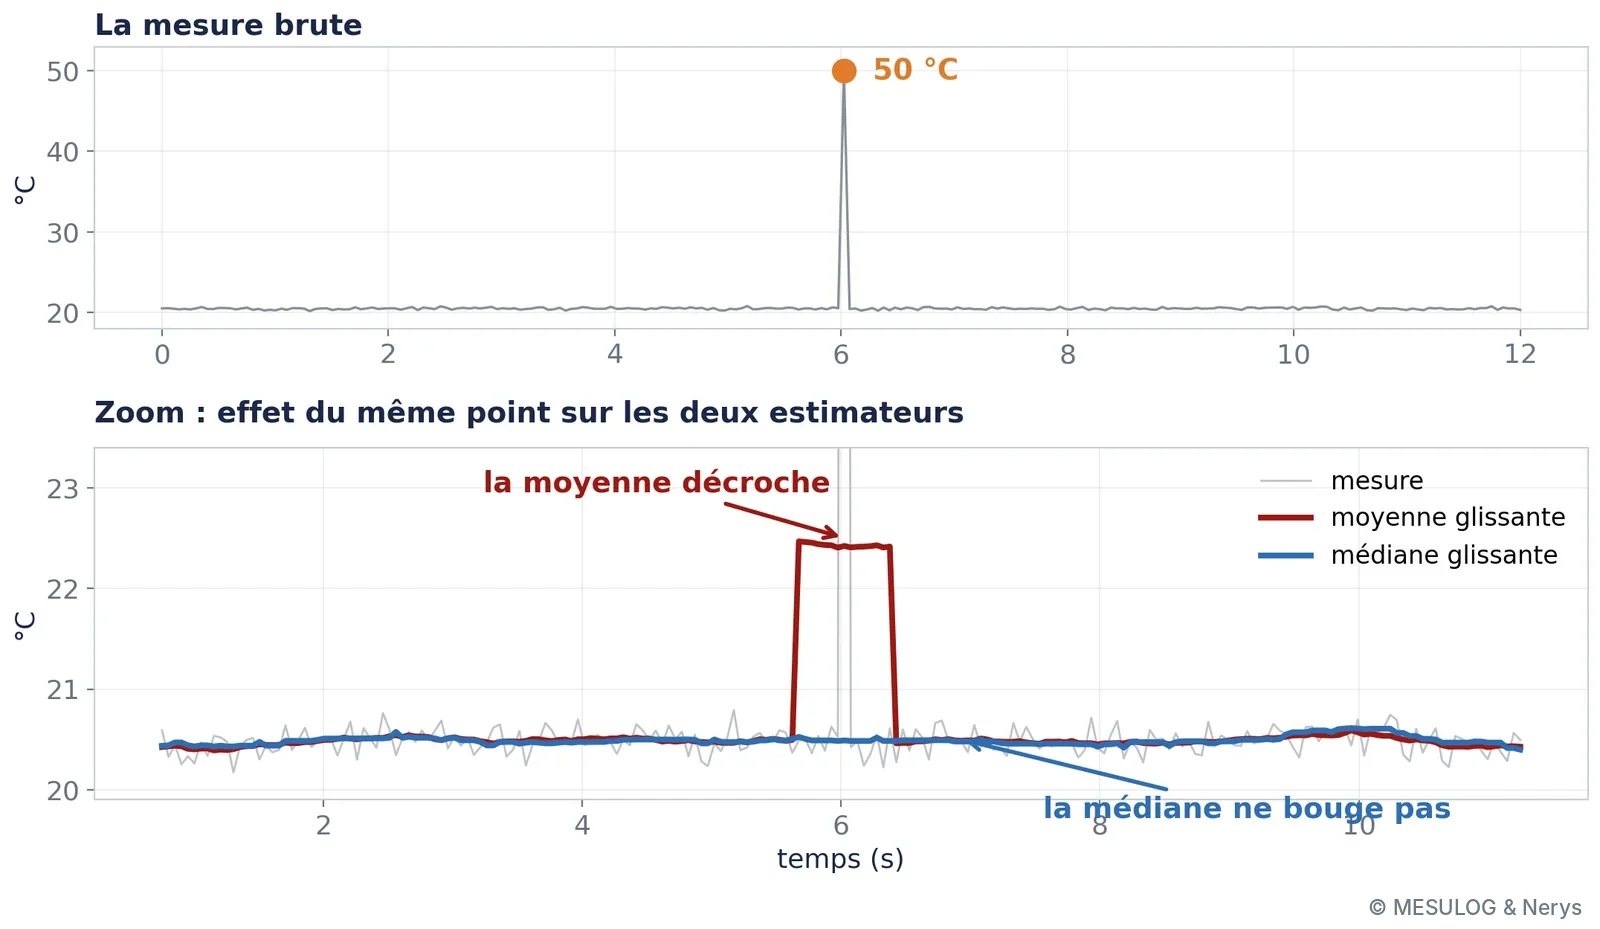
Ce n'est pas que l'une soit meilleure que l'autre. Ce sont deux hypothèses différentes sur la nature du bruit : la moyenne suppose un bruit symétrique et sans valeurs extrêmes, la médiane suppose que les valeurs extrêmes sont rares et sans signification. Choisir l'une, c'est déjà décider quelque chose sur le phénomène et sur la chaîne de mesure.
Le prix du lissage : le retard
Puis le phénomène physique évolue réellement : la température monte de 20 à 25 °C, puis à 30 °C. Le filtre qui protégeait du bruit devient alors un handicap. Une moyenne ou une médiane sur 25 points ne suit un échelon qu'après une douzaine d'échantillons, la moitié de la fenêtre, et la moyenne le suit en rampe là où la médiane bascule d'un coup quand la majorité de la fenêtre a changé. Plus on lisse, plus on réagit tard.
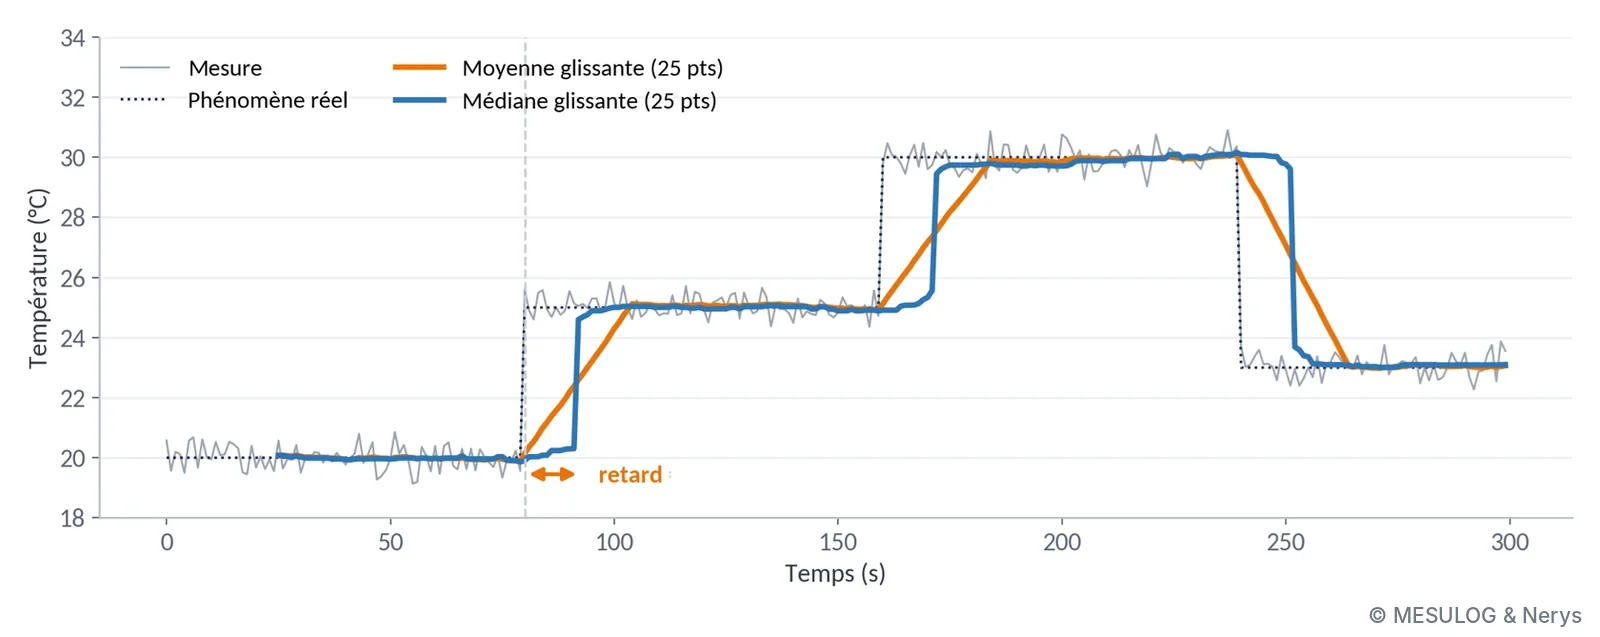
C'est le compromis de base de tout traitement, et il ne se règle pas par la technique. Il se règle en répondant à une question métier : combien de temps a-t-on pour réagir, et combien de fausses alarmes est-on prêt à accepter ? Un banc d'endurance qui enregistre une température d'huile sur trois semaines et une boucle de sécurité qui doit couper en une seconde n'appellent pas le même filtre, même avec le même capteur.
NB : la moyenne elle-même demande de savoir ce qu'on manipule. La moyenne arithmétique de 350° et de 10° vaut 180°, soit exactement l'opposé de la réalité, alors que les deux directions sont à 10° du nord. Le calcul est juste, l'outil est juste, et le résultat est faux, parce qu'un angle est une grandeur circulaire. La bonne méthode moyenne les sinus et les cosinus, puis recompose l'angle avec un arc tangente à deux arguments : on obtient 0°. La même précaution vaut pour une phase, une heure de la journée ou une position angulaire de codeur.
2. Un pic ou une rupture ?
Même signal, un point sort du lot. Faut-il l'éliminer ou le conserver ? S'il s'agit d'un parasite, on l'élimine. S'il s'agit du premier point d'un nouveau régime, ou du début d'une rupture, l'éliminer revient à masquer exactement ce qu'on cherchait. Sur un seul échantillon, les deux cas se ressemblent trait pour trait. C'est ce qui se passe après qui les distingue, et c'est ce que la statistique permet de décider proprement.
La loi gaussienne comme règle de décision
Si le bruit de mesure résulte de nombreux petits effets indépendants, ce qui est le cas du bruit thermique, du bruit de quantification et de la plupart des perturbations d'une chaîne bien conçue, sa distribution est gaussienne. Deux nombres la décrivent entièrement : la moyenne μ et l'écart-type σ. Dans l'exemple présenté, μ = 20,50 °C et σ = 0,45 °C.
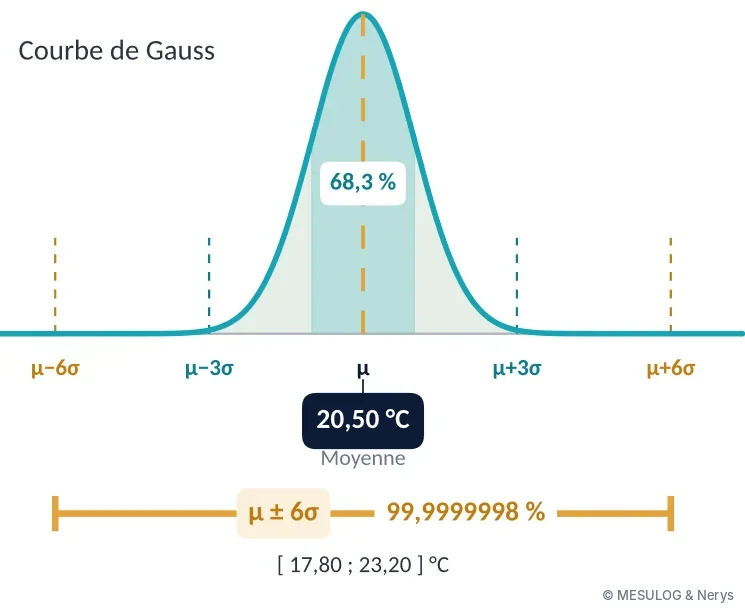
La fenêtre μ ± 3σ contient 99,73 % des mesures d'un régime stable : un point sur 370 en sort, ce qui est bien trop fréquent pour déclencher une décision. La fenêtre μ ± 6σ en contient 99,9999998 % : un point sur 500 millions environ. Avec une mesure par seconde, c'est une fausse alarme tous les seize ans. Un point hors de cette fenêtre a donc deux explications plausibles : le système a changé, ou la mesure est corrompue. Dans les deux cas, il faut faire quelque chose.
Dans la démonstration, la fenêtre μ ± 6σ va de 17,80 à 23,20 °C. Un point arrive à 25,5 °C, puis un deuxième, puis un troisième : la rupture est détectée, le filtre est réinitialisé sur le nouveau régime au lieu de le lisser pendant 25 échantillons, et la décision suit immédiatement le phénomène.
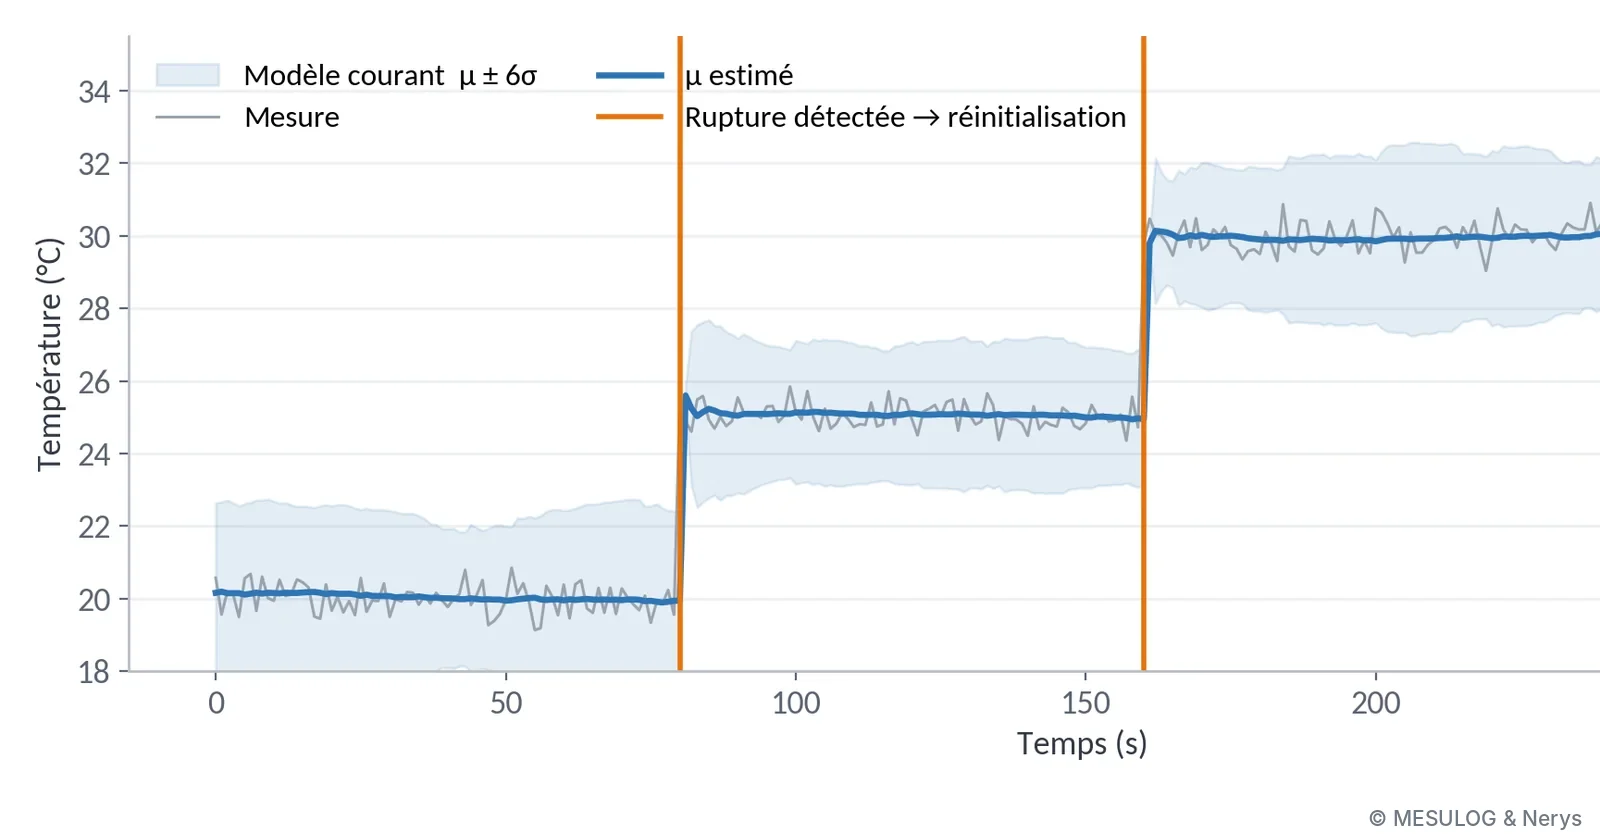
Mise en garde : un écart supérieur à 6σ ne prouve pas une rupture. Il signale une observation incompatible avec le modèle de bruit retenu, à condition que les hypothèses de ce modèle tiennent. Si le bruit n'est pas gaussien, s'il comporte des impulsions régulières ou une dérive lente, la règle ne vaut rien, et c'est l'analyse de la chaîne de mesure qui doit dire quel modèle de bruit retenir. On en revient à la même phrase : ça marche parce qu'on sait ce qu'on cherche.
Les mêmes outils pour piloter la qualité d'une production
Ces outils servent à autre chose qu'à filtrer : ils mesurent la qualité d'un procédé. Sur les bancs de production que Mesulog et Nerys développent avec un séquenceur de tests TestStand, chaque pas de test est une mesure, avec ses limites, son verdict et son contexte (numéro de série, station, opérateur). La plateforme WATS collecte ces résultats sans ressaisie : un reporter branché sur TestStand envoie le rapport de chaque pièce en fin de test vers une base centralisée, dans le nuage ou sur les serveurs du client. À partir de là, toute l'équipe analyse les mêmes données, dès la première pièce.
L'exemple présenté vient d'un vrai banc : le pas de test « Measure VCC », une alimentation théorique de 5 V, avec 9 862 mesures collectées. La moyenne vaut 4,996 V : le procédé est centré. L'écart-type vaut environ 0,026 V : la dispersion μ ± 3σ va de 4,918 à 5,074 V, loin des limites de spécification fixées à 4,8 et 5,2 V.
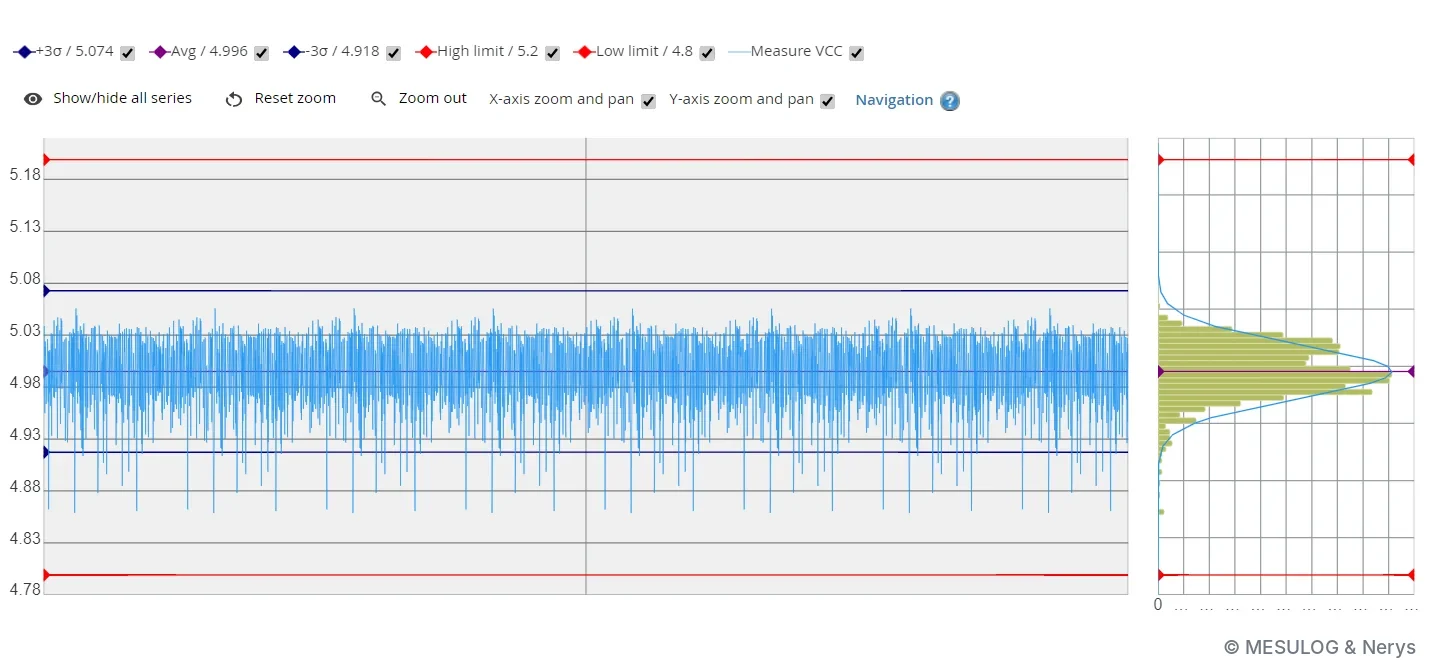
« Loin des limites » est un ressenti. La capabilité du procédé en fait un chiffre comparable d'un banc à l'autre : Cpk = min[(LSS − μ) / 3σ ; (μ − LSI) / 3σ], où LSS et LSI sont les limites supérieure et inférieure. Ici, (5,2 − 4,996) / 0,078 ≈ 2,6 côté haut et (4,996 − 4,8) / 0,078 ≈ 2,5 côté bas : le Cpk vaut environ 2,5, là où l'objectif courant en production est de 1,33. Un Cpk inférieur à 1 signifie qu'une part de la production sortira des limites même si le procédé ne dérive pas ; un Cpk de 2,5 laisse une marge confortable, et permet par exemple de discuter d'un allègement de contrôle.
Les indicateurs de rendement complètent le tableau. Le FPY (first pass yield) est le taux de produits conformes dès le premier passage ; le SPY, le TPY et le LPY suivent les deuxième, troisième et dernier passages. L'écart entre FPY et LPY mesure ce que coûtent les retests. Le Pareto des dix pas de test les plus souvent en échec dit où se concentrent les défauts, celui des dix Cpk les plus faibles dit où agir en priorité, et une carte CUSUM, qui cumule les écarts à la cible, signale une dérive lente avant le premier échec.
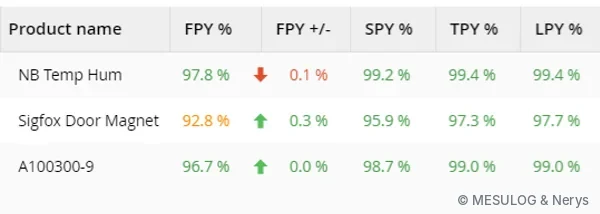
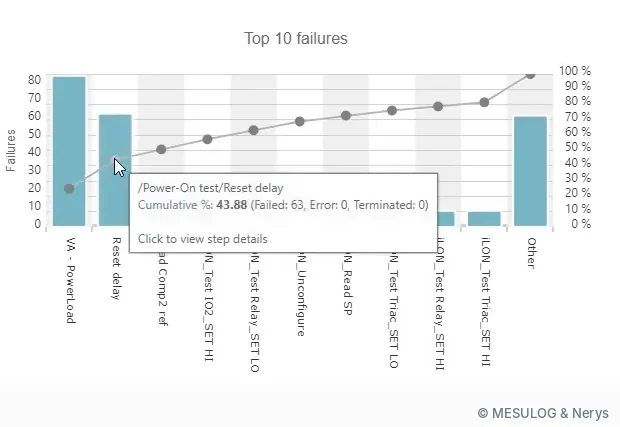
WATS propose depuis peu deux prolongements qui relèvent de l'IA : un assistant intégré qui suggère des regroupements et des causes racines (par opérateur, par lot), et un connecteur MCP qui permet à un assistant comme Claude ou ChatGPT d'interroger directement la base de tests en langage naturel : « qu'est-ce qui a fait chuter le FPY la semaine dernière ? », « quelles stations génèrent le plus de retests ? ». La question reste posée par quelqu'un qui sait ce qu'est un FPY et pourquoi il a chuté ; l'outil va simplement chercher plus vite.
3. L'épaisseur d'une plaque : la régression linéaire
Troisième exemple, une mesure dimensionnelle : l'épaisseur d'une plaque de marbre sur un convoyeur, avec une cote nominale de 20,0 mm. Un profilomètre laser 2D (un Keyence, dans le montage réel) projette une ligne laser sur le bord de la plaque et renvoie, à chaque profil, un nuage de points hauteur en fonction de la position. Il faut en extraire une épaisseur, avec son incertitude.
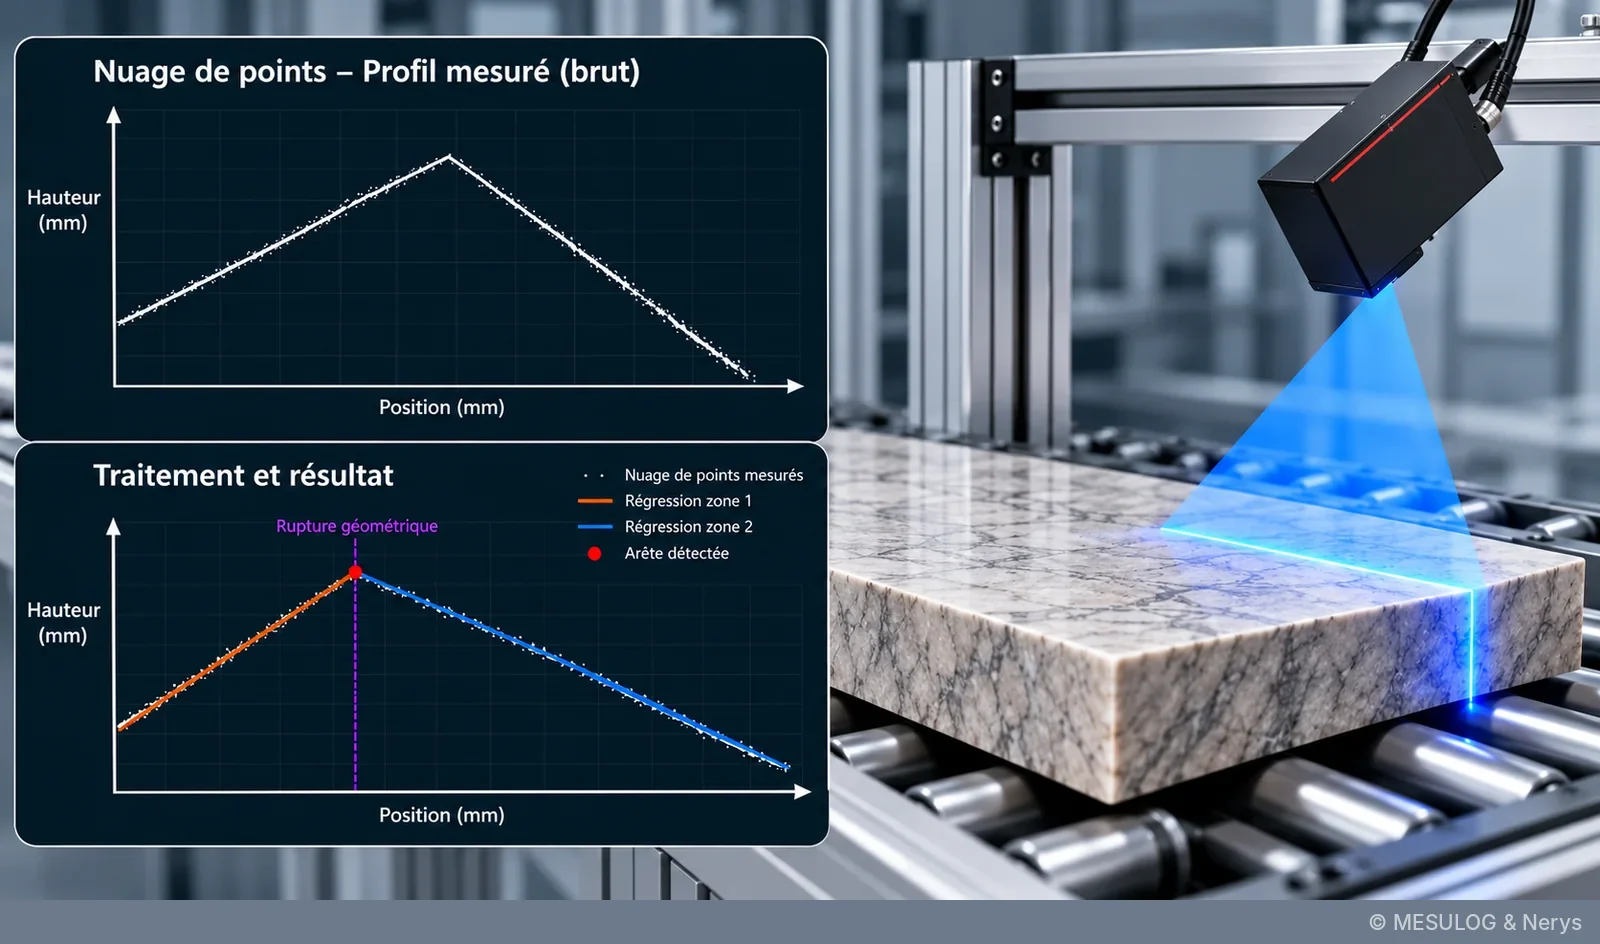
Le nuage est imparfait : bruit de mesure, points manquants sur les surfaces brillantes ou trop inclinées, arête arrondie qui ne donne pas d'angle net. Prendre le point le plus haut et le point le plus bas ne donne pas une épaisseur, mais la hauteur du grain le plus saillant.
La méthode, en trois temps
Premier temps, découper le profil en zones : la zone supérieure, quasi horizontale, et la zone latérale, quasi verticale. La frontière se trouve en cherchant la rupture géométrique, l'endroit où la pente locale change brutalement. Deuxième temps, modéliser la surface supérieure par une droite, ajustée par la méthode des moindres carrés : la droite qui minimise la somme des carrés des écarts verticaux entre les points et le modèle. Avec quelques centaines de points, le bruit de chaque point se moyenne, et la droite est bien plus juste que n'importe quel point isolé. Troisième temps, calculer l'épaisseur par projection orthogonale du point extrême de la face latérale sur cette droite. La dispersion des résidus de l'ajustement donne, au passage, une estimation de l'incertitude de la mesure.
Rien de révolutionnaire : la méthode des moindres carrés est publiée par Legendre en 1805. Elle fonctionne parce que la géométrie de la pièce est connue : la surface supérieure est plane, le bord est sensiblement perpendiculaire. Sur une pièce bombée, la même droite donnerait un résultat faux, avec des résidus plus grands mais une incertitude d'apparence rassurante si personne ne regarde leur forme. Là encore, c'est la connaissance de l'objet mesuré qui choisit le modèle.
Une régression linéaire, c'est un neurone
Cet exemple servait aussi de passerelle vers la suite. Une régression linéaire, y = a·x + b, c'est un neurone : le coefficient a est le poids, l'ordonnée à l'origine b est le biais, et l'ajustement par moindres carrés est son apprentissage. Tout le monde dans la salle en faisait depuis des années sans le savoir.
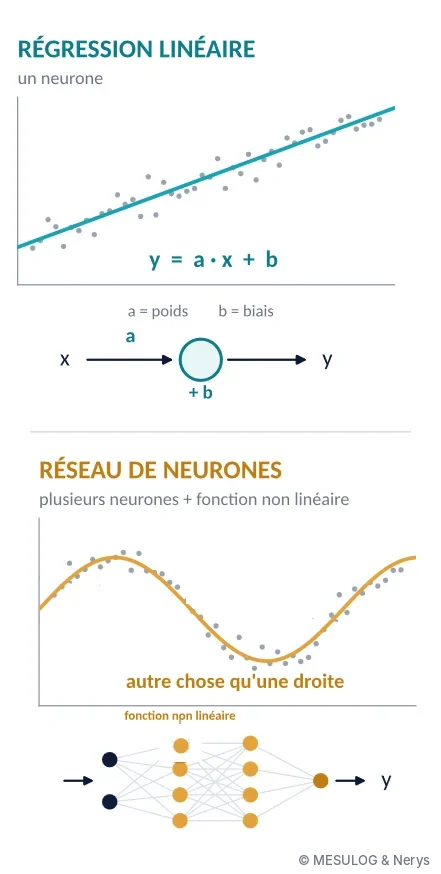
Un réseau de neurones combine beaucoup de ces éléments, et intercale entre eux une fonction non linéaire qui permet de représenter autre chose qu'une droite. Presque toutes les méthodes que l'on appelle aujourd'hui intelligence artificielle sont anciennes : la régression date de 1805, les cartes de contrôle de 1924, le perceptron de 1958, la rétropropagation qui rend les réseaux multicouches entraînables de 1986, les réseaux convolutifs de 1989. Ce qui a changé, c'est la puissance de calcul et le volume de données disponibles, pas la nature mathématique des outils.
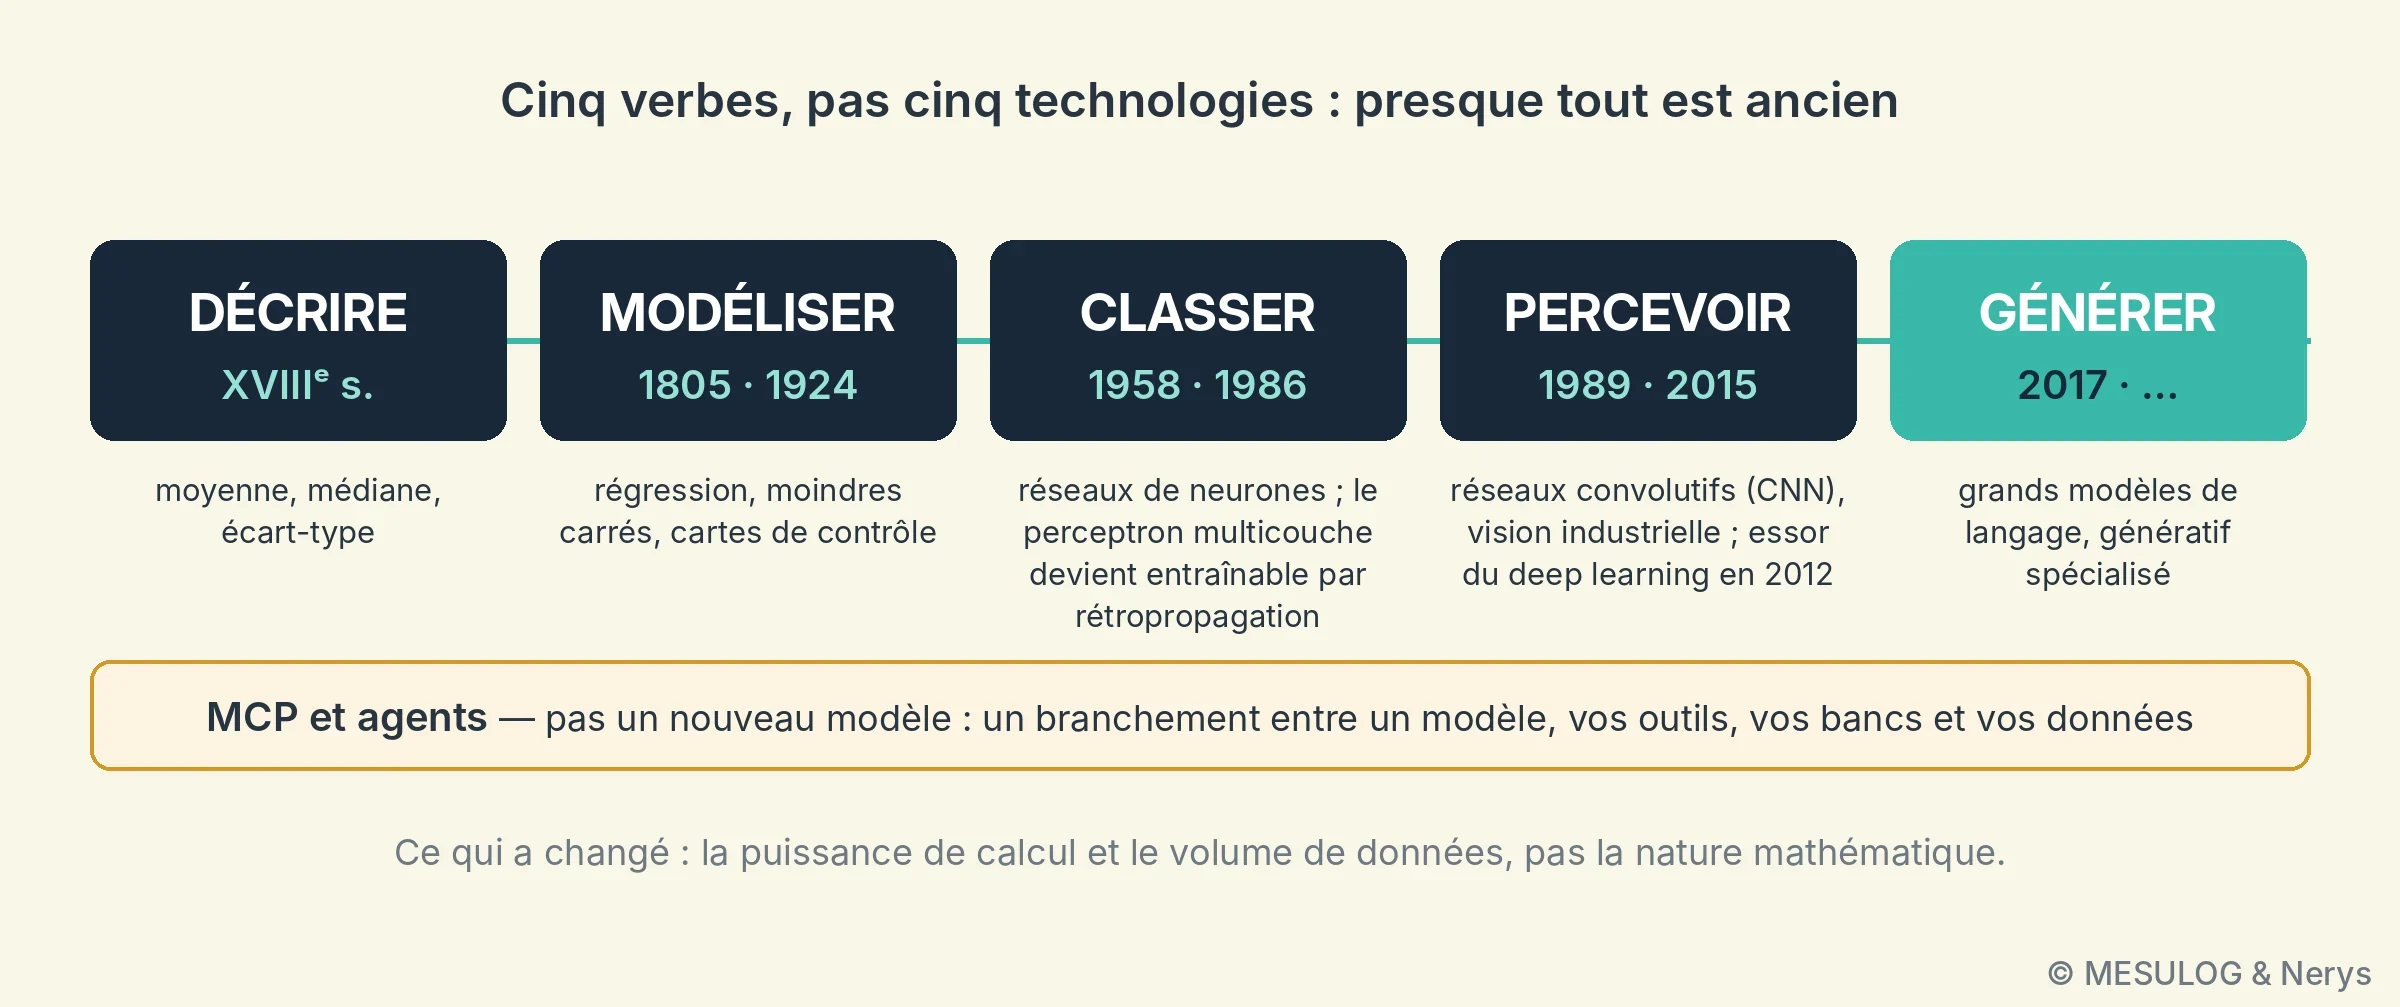
Les intervenants ont présenté cette évolution comme cinq verbes plutôt que cinq technologies : décrire, modéliser, classer, percevoir, générer. Classer, c'est ce qui décide bon ou mauvais en bout de banc ; ça tourne chez la plupart des industriels depuis vingt ans, et personne ne l'appelait IA. La frontière est assez arbitraire. Quant au MCP (Model Context Protocol), ce n'est pas une famille de modèles mais un protocole de connexion entre un modèle et vos outils, vos bancs et vos données : un branchement, pas un cerveau de plus.
4. Reconnaître des dés : la vision industrielle par réseau de neurones
Sur le stand B53, Nerys et Mesulog avaient monté un jeu : Humain contre IA. Le visiteur lance deux dés dans un bac, calcule la somme des faces visibles et la tape sur un clavier ; pendant ce temps, une caméra intelligente identifie les faces, calcule la somme et rend son verdict. Le plus rapide des deux gagne. Le jeu tourne dans Vasco, le logiciel de pilotage de bancs édité par Nerys : il déclenche la caméra, récupère son résultat, chronomètre les deux joueurs et affiche le score. Pour compliquer la tâche, le bac contenait aussi des dés blancs illustrés, souvenir des dix ans du salon, qui comptent pour zéro point.
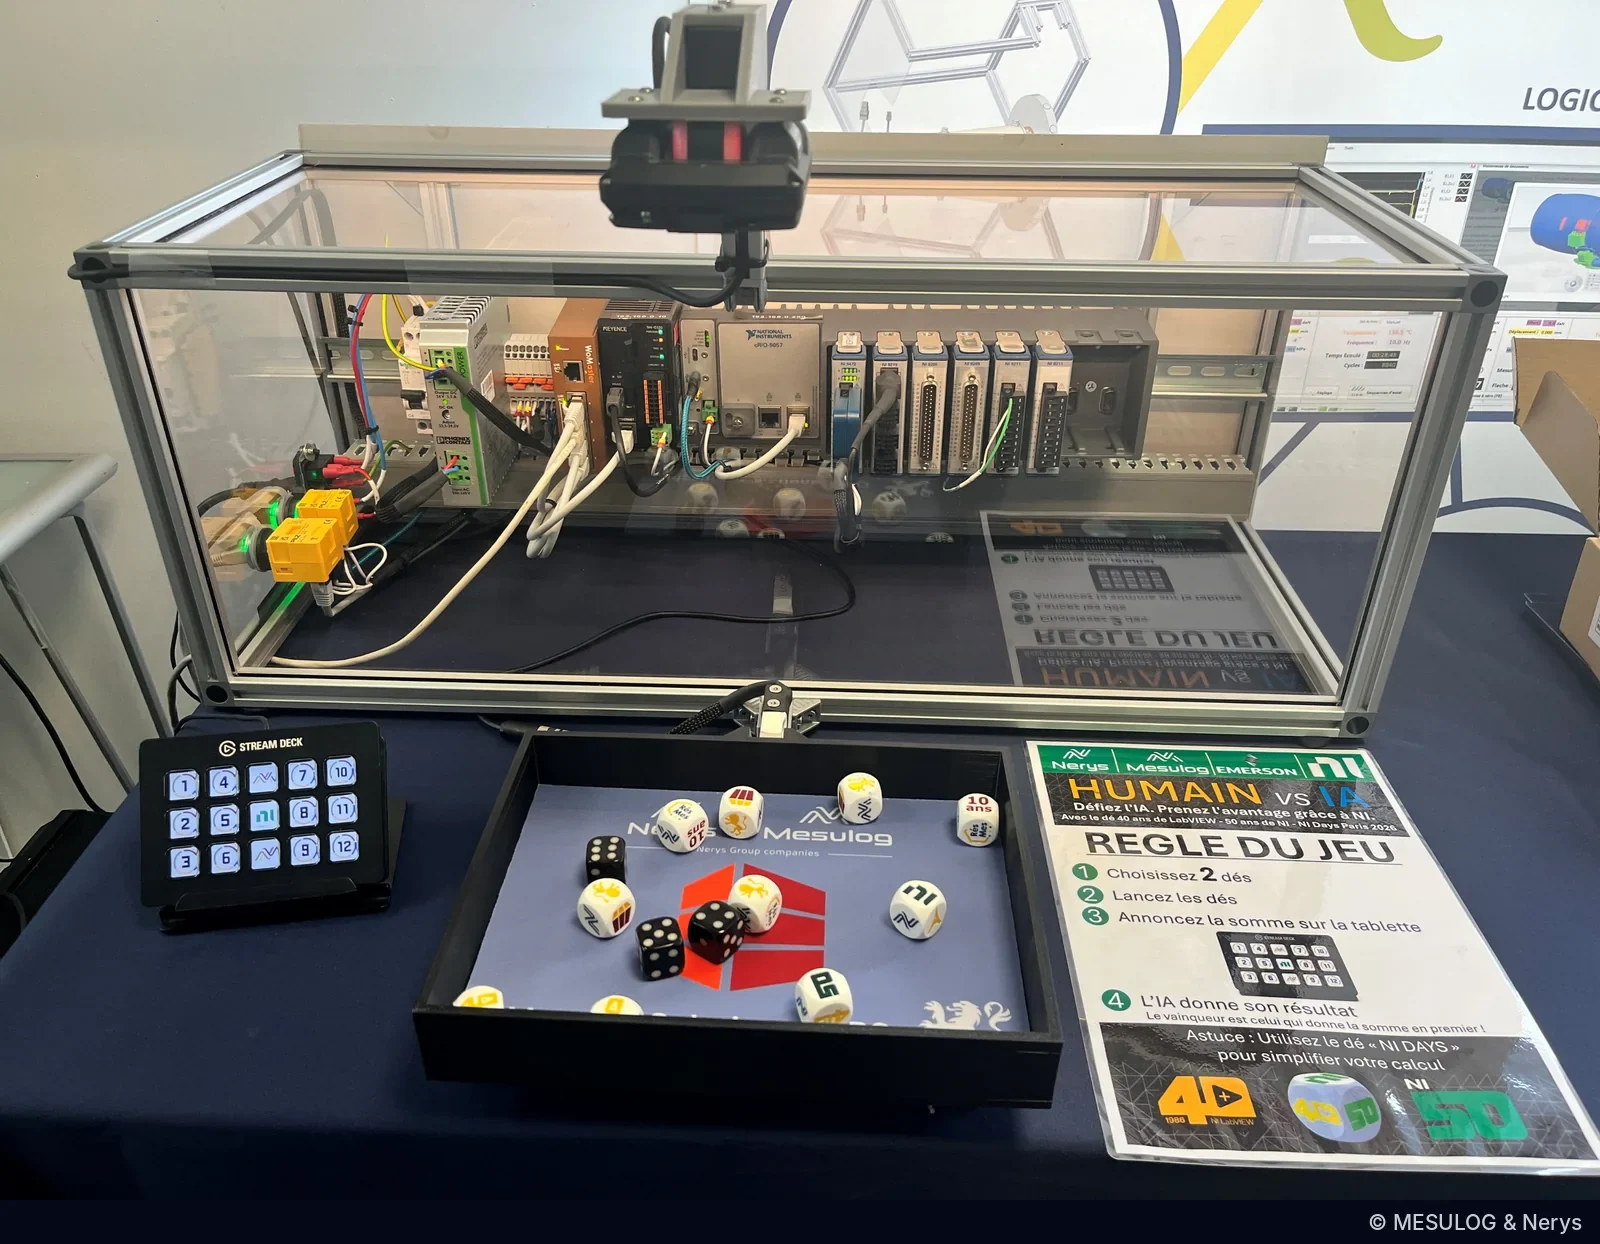
Une image, treize décisions
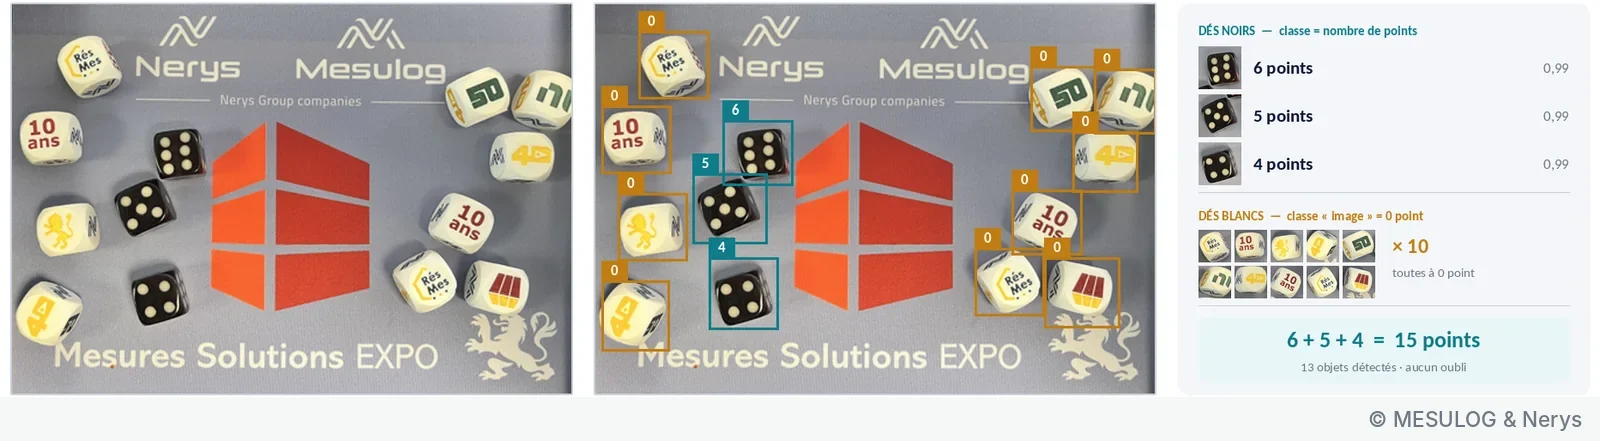
Derrière le jeu, un réseau de détection d'objets de la famille des réseaux convolutifs (CNN), le principe des détecteurs de type YOLO : à partir d'une seule image, il localise chaque objet, l'encadre et le classe. Sur l'image ci-dessous, treize objets sont détectés : trois dés noirs, classés « 4 points », « 5 points » et « 6 points » avec une confiance de 0,99, et dix dés blancs classés « image », qui valent zéro. La somme, 15, n'est pas calculée par le réseau.
À l'intérieur du réseau, les premières couches ne voient que des contours : sur une vignette de 64 × 64 pixels autour d'un dé, huit cartes de convolution font ressortir les bords et les points. Les couches suivantes combinent ces motifs, et la sortie n'est pas « 5 » mais une probabilité par classe : 96,4 % pour « 5 points », 1,9 % pour « 6 points », 0,9 % pour « 4 points », 0,8 % pour « image ».
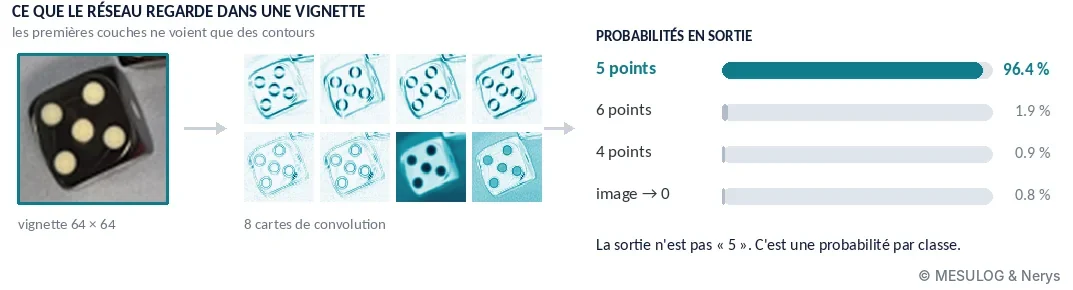
Ce point a une conséquence directe : l'IA reconnaît les objets, c'est le logiciel qui applique les règles du jeu et prend la décision. Il vérifie qu'il y a bien deux dés comptables, additionne, compare et chronomètre ; les seuils de confiance, eux, se règlent et se tracent comme des paramètres du programme. Cette répartition vaut pour n'importe quel contrôle visuel en bout de ligne : le réseau perçoit, le logiciel décide, et le logiciel, lui, se vérifie, se versionne et se recette comme n'importe quel autre.
Ce qu'on n'a pas eu à faire
Sur le stand, la reconnaissance tournait dans une caméra Keyence IV4, qui embarque son propre apprentissage : pas de PC dédié, pas de code. La configuration se fait en quatre étapes guidées : optimiser l'image (déclenchement, éclairage), enregistrer une image de référence, régler les outils, attribuer les sorties. L'équipe avait défini huit outils : un par face de dé, un pour le total, un pour le logo. Le cycle complet de contrôle prend environ une seconde, et le verdict, le comptage et le taux de correspondance sortent sur des entrées-sorties et sur Ethernet, que Vasco exploite directement.
Ce qui surprend, c'est ce qu'on n'a pas fait : écrire le réseau, ou programmer des règles de reconnaissance des faces (« compter les taches noires sur fond blanc… »). On définit les objets à reconnaître, on fournit des images annotées de chaque face, et le réseau apprend à les séparer. Quand une cible est manquée en production, l'opérateur l'encadre sur l'image, lui donne son étiquette et relance l'apprentissage, en quelques secondes.
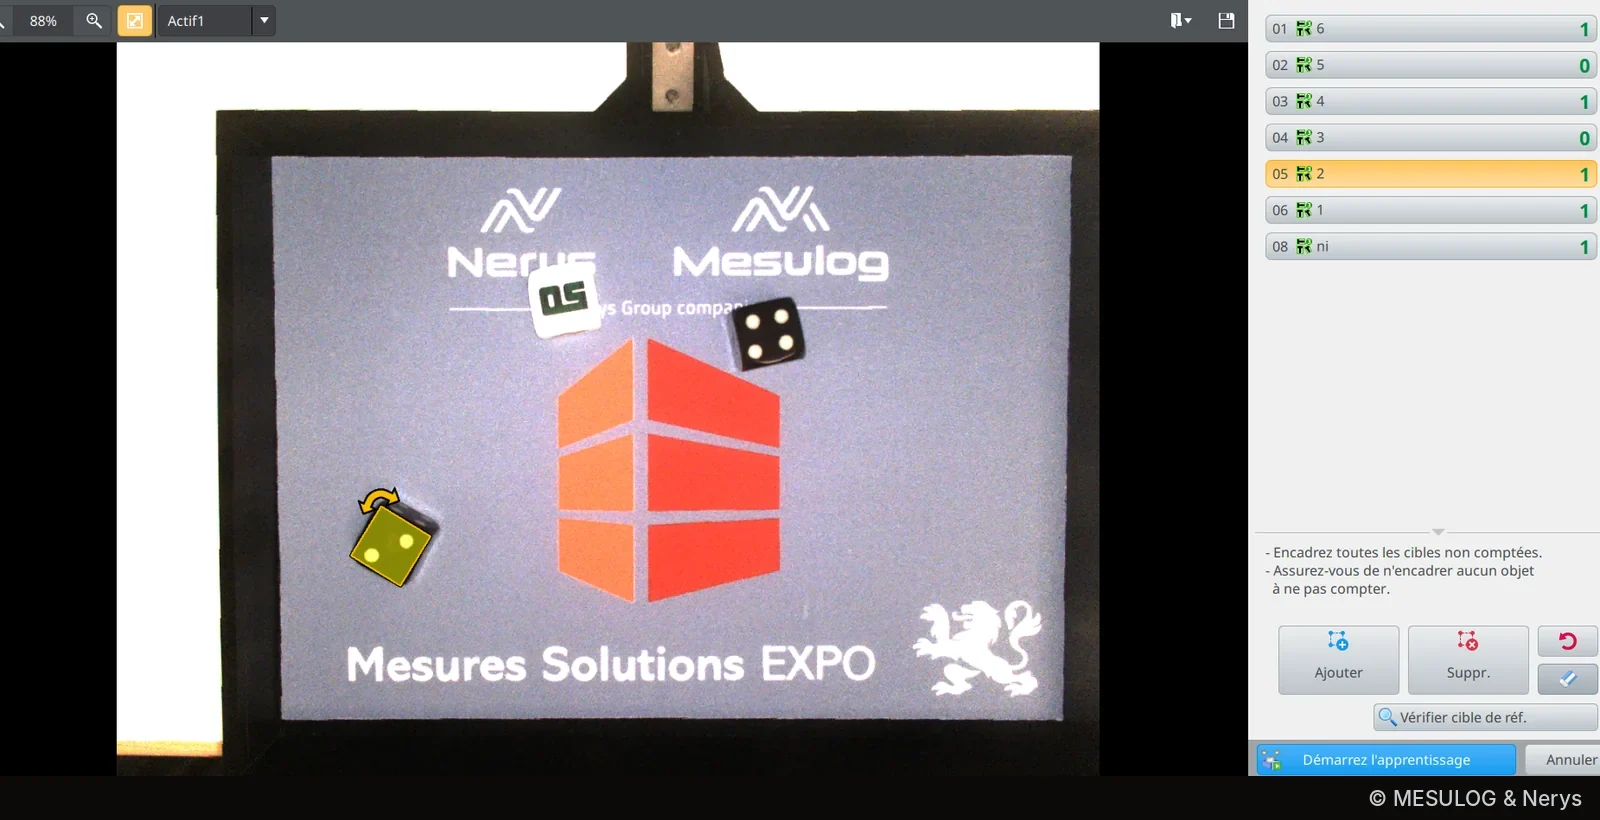
Mise en garde, valable pour toutes les caméras de ce type : un réapprentissage est une modification du programme de contrôle. Qui a réappris quoi, quand, et sur quelles images, doit être tracé comme une version de logiciel. Une caméra qui « apprend » sans trace est un instrument dont on ne sait plus dire ce qu'il mesure.
5. Prédire le passage à zéro d'un courant de court-circuit, avec Schneider Electric
C'est l'exemple qu'Amaury Laurent a dû le plus survoler, et celui qui mérite le plus de place. Il répond à une question qui paraît absurde posée comme ça : peut-on agir avant que le signal soit là ?
Un siècle d'essais à Grenoble. Pour comprendre le besoin, il faut dire deux mots du lieu. Schneider Electric est née en 1836 au Creusot sous le nom de Schneider et Cie ; le groupe compte aujourd'hui plus de 150 000 salariés dans plus de 100 pays, pour 40 milliards d'euros de chiffre d'affaires en 2025. Son ancrage grenoblois vient de Merlin Gerin, fondée en 1920 par deux ingénieurs des Arts et Métiers, Paul-Louis Merlin et Gaston Gerin, autour des disjoncteurs moyenne et haute tension à bain d'huile. Dès 1921, l'entreprise se dote d'un laboratoire d'essais, le laboratoire Volta, pour éprouver ses appareils en haute tension ; il montera à 800 kV dans les années 1930. En 1946, Merlin Gerin présente son premier disjoncteur capable de couper un court-circuit de 10 000 A sous 15 000 V, et dans les années 1960 Grenoble abrite l'un des plus grands laboratoires d'essais diélectriques d'Europe. Rachetée par Schneider en 1992, l'entreprise est aujourd'hui entièrement intégrée à Schneider Electric, qui a gardé la marque. Le site de Technopole, dans les anciens locaux de Merlin Gerin, reste le cœur grenoblois du groupe pour l'appareillage de coupure : 1 200 salariés, ses laboratoires et ses fonctions support.
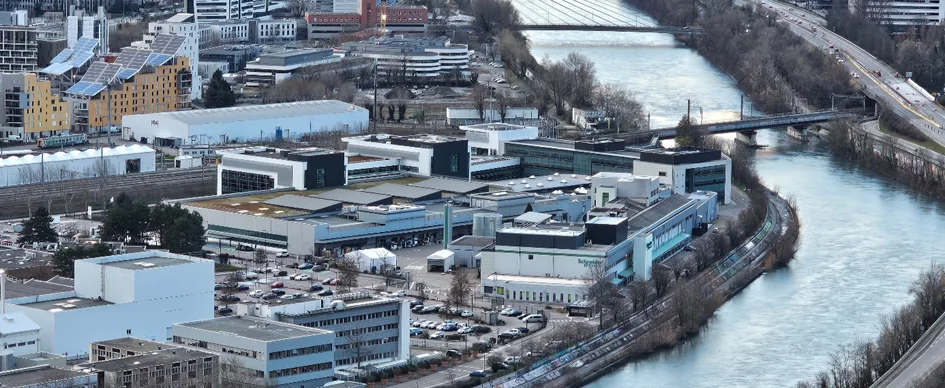
F-Lab et le LEMT. Deux laboratoires principaux y cohabitent. F-Lab est le laboratoire d'essais et de certification de Schneider Electric en France : deux plateformes dans l'agglomération, Volta à Grenoble et Amplitude à Eybens, 14 000 m² d'essais basse et moyenne tension, une centaine d'ingénieurs et techniciens, une accréditation COFRAC selon l'ISO/IEC 17025, et des essais réalisés sous le regard d'organismes tiers comme l'ASEFA ou le LCIE pour la certification des produits. Pour les essais de forte puissance, il dispose de trois alternateurs d'essai, deux de 600 MVA et un de 2 500 MVA, capables de délivrer de l'ordre de 300 kA pendant une seconde en basse tension ; c'est ce genre de machine qui produit les courants de court-circuit de cette histoire. À côté, le LEMT, laboratoire d'essais moyenne tension, prend en charge les essais spécifiques et les développements sur l'appareillage de coupure. C'est avec ses équipes que Nerys et Mesulog ont travaillé.
Ce que ces laboratoires savent faire, et ce qu'ils ont demandé. L'expertise du site tient en trois mots : appareillage de coupure, physique de l'arc, normes d'essai. Couper un courant de court-circuit, c'est maîtriser un arc électrique qui s'établit entre deux contacts qui s'ouvrent, avec ses phénomènes de pré-arc, et les normes de certification décrivent précisément les conditions dans lesquelles la coupure doit réussir.
Certains de ces essais imposent de commander des commutateurs rapides à un instant précis par rapport au passage à zéro du courant, pour assurer la transition entre des sources de forte puissance tout en limitant l'énergie d'arc dans l'objet testé s'il venait à s'amorcer. Les ordres doivent partir plusieurs centaines de microsecondes avant le zéro, pour absorber les latences de la chaîne de commutation, avec une précision de l'ordre de la dizaine de microsecondes. Les corrections d'anticipation doivent pouvoir se régler finement et indépendamment pour chaque action et chaque phase, y compris sur des séquences d'actions rapprochées, et certaines actions doivent partir à l'échelle de la microseconde sur dépassement d'une grandeur. Et tout cela sur une onde dont ni la fréquence ni l'amplitude ne sont stables. Voilà le besoin tel qu'il a été posé à Nerys et Mesulog.
Ce que le signal impose. Avant toute méthode, l'équipe a regardé les enregistrements du laboratoire, acquis à 1 MHz sur le banc de court-circuit : douze enregistrements de référence, treize voies de courant exploitables, des pics de plusieurs dizaines de kiloampères. Aucune simulation ne remplace une campagne d'essai, et tout ce qui suit est contraint par ce que ces enregistrements contiennent. Ils imposent quatre contraintes.
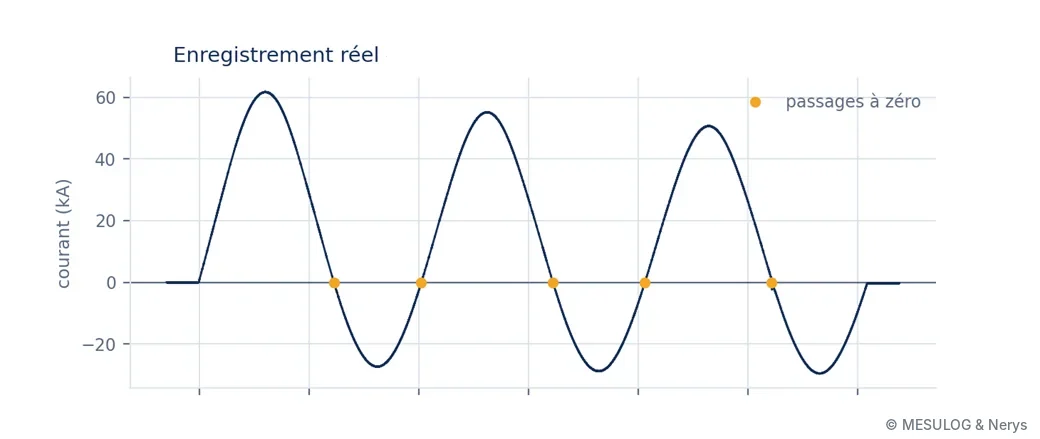
D'abord une composante apériodique : le circuit est inductif, et le courant de défaut est une sinusoïde décalée par une exponentielle décroissante dont la constante de temps vaut une vingtaine de millisecondes. Sur l'essai ci-dessus, l'onde monte à +62 kA d'un côté et redescend à −28 kA de l'autre ; les zéros ne sont donc pas espacés de 10 ms. Ensuite, la fréquence n'est pas à 50 Hz : la génératrice du banc ralentit sous le couple de court-circuit, et l'équipe a mesuré de 50,7 à 48,7 Hz selon les voies. À 2,6 % d'écart, une prédiction émise 1 ms avant le zéro en supposant 50 Hz se trompe déjà de 26 µs. Sur ces enregistrements, le défaut ne dure que 50 à 65 ms, soit trois périodes : on voit le début du ralentissement, pas son installation. Troisième contrainte, le bruit exclut toute méthode locale : avec un écart-type d'environ 48 A avant le défaut et une pente au zéro qui descend jusqu'à 5,9 A/µs, une détection par seuil gigue de 16 µs, pour un budget de 10. Estimer la fréquence sur une seule alternance donne n'importe quoi entre 42 et 60 Hz, parce que l'offset décale les zéros ; sur une période entière, l'asymétrie se compense et l'on trouve 50,1 Hz. Il faut un modèle qui sépare explicitement l'offset de la sinusoïde. Enfin, il faut être prêt à piloter 5 ms après l'établissement du courant, soit un quart de période : l'estimateur n'a pas le droit d'être lent à converger.
La méthode, dans les grandes lignes. Tout part d'un modèle analytique du courant de défaut, qui n'a rien de secret puisque c'est la physique d'un circuit inductif mis en court-circuit :
I(t) = a·sin(ωt) + b·cos(ωt) + C + d·e−t/τ
Les termes en sinus et cosinus portent l'amplitude et la phase du fondamental, C est un offset continu résiduel, et le terme exponentiel est la composante apériodique, avec sa constante de temps τ. La pulsation ω n'est pas fixée à 50 Hz : elle fait partie des inconnues.
Le principe est alors d'identifier ces paramètres en continu, par moindres carrés, sur les échantillons déjà acquis. À chaque nouvel échantillon, l'écart entre la mesure et ce que prédit le modèle, l'innovation, sert à corriger l'estimation de façon récursive, avec un oubli progressif des échantillons anciens pour suivre l'évolution du signal. C'est la régression linéaire de l'exemple 3, mise à jour un million de fois par seconde. En parallèle, une boucle à verrouillage de fréquence corrige la pulsation : la fréquence est suivie, pas supposée. Une fois les paramètres connus, l'instant du prochain passage à zéro se déduit du modèle par une formule fermée : pas de recherche, pas d'itération. C'est ce point qui rend le coût de calcul constant par échantillon, et donc compatible avec un FPGA qui traite un échantillon par microseconde sur trois voies de courant simultanées. En virgule fixe, la manière d'écrire la récursion n'est pas anodine : certaines formulations classiques dérivent numériquement jusqu'à faire diverger l'estimation, et l'équipe en a retenu une qui reste stable. Le détail de ces rouages, les pondérations et le paramétrage restent entre Nerys, Mesulog et Schneider.
La vidéo ci-dessous rejoue un enregistrement réel du laboratoire. En haut, la mesure et le modèle estimé, superposés dès les premières millisecondes ; en bas, la distance au prochain passage à zéro calculée à chaque microseconde. Le déclenchement est demandé 100 µs avant le zéro prédit ; l'écart entre le zéro réel et l'instant visé est affiché à chaque passage.
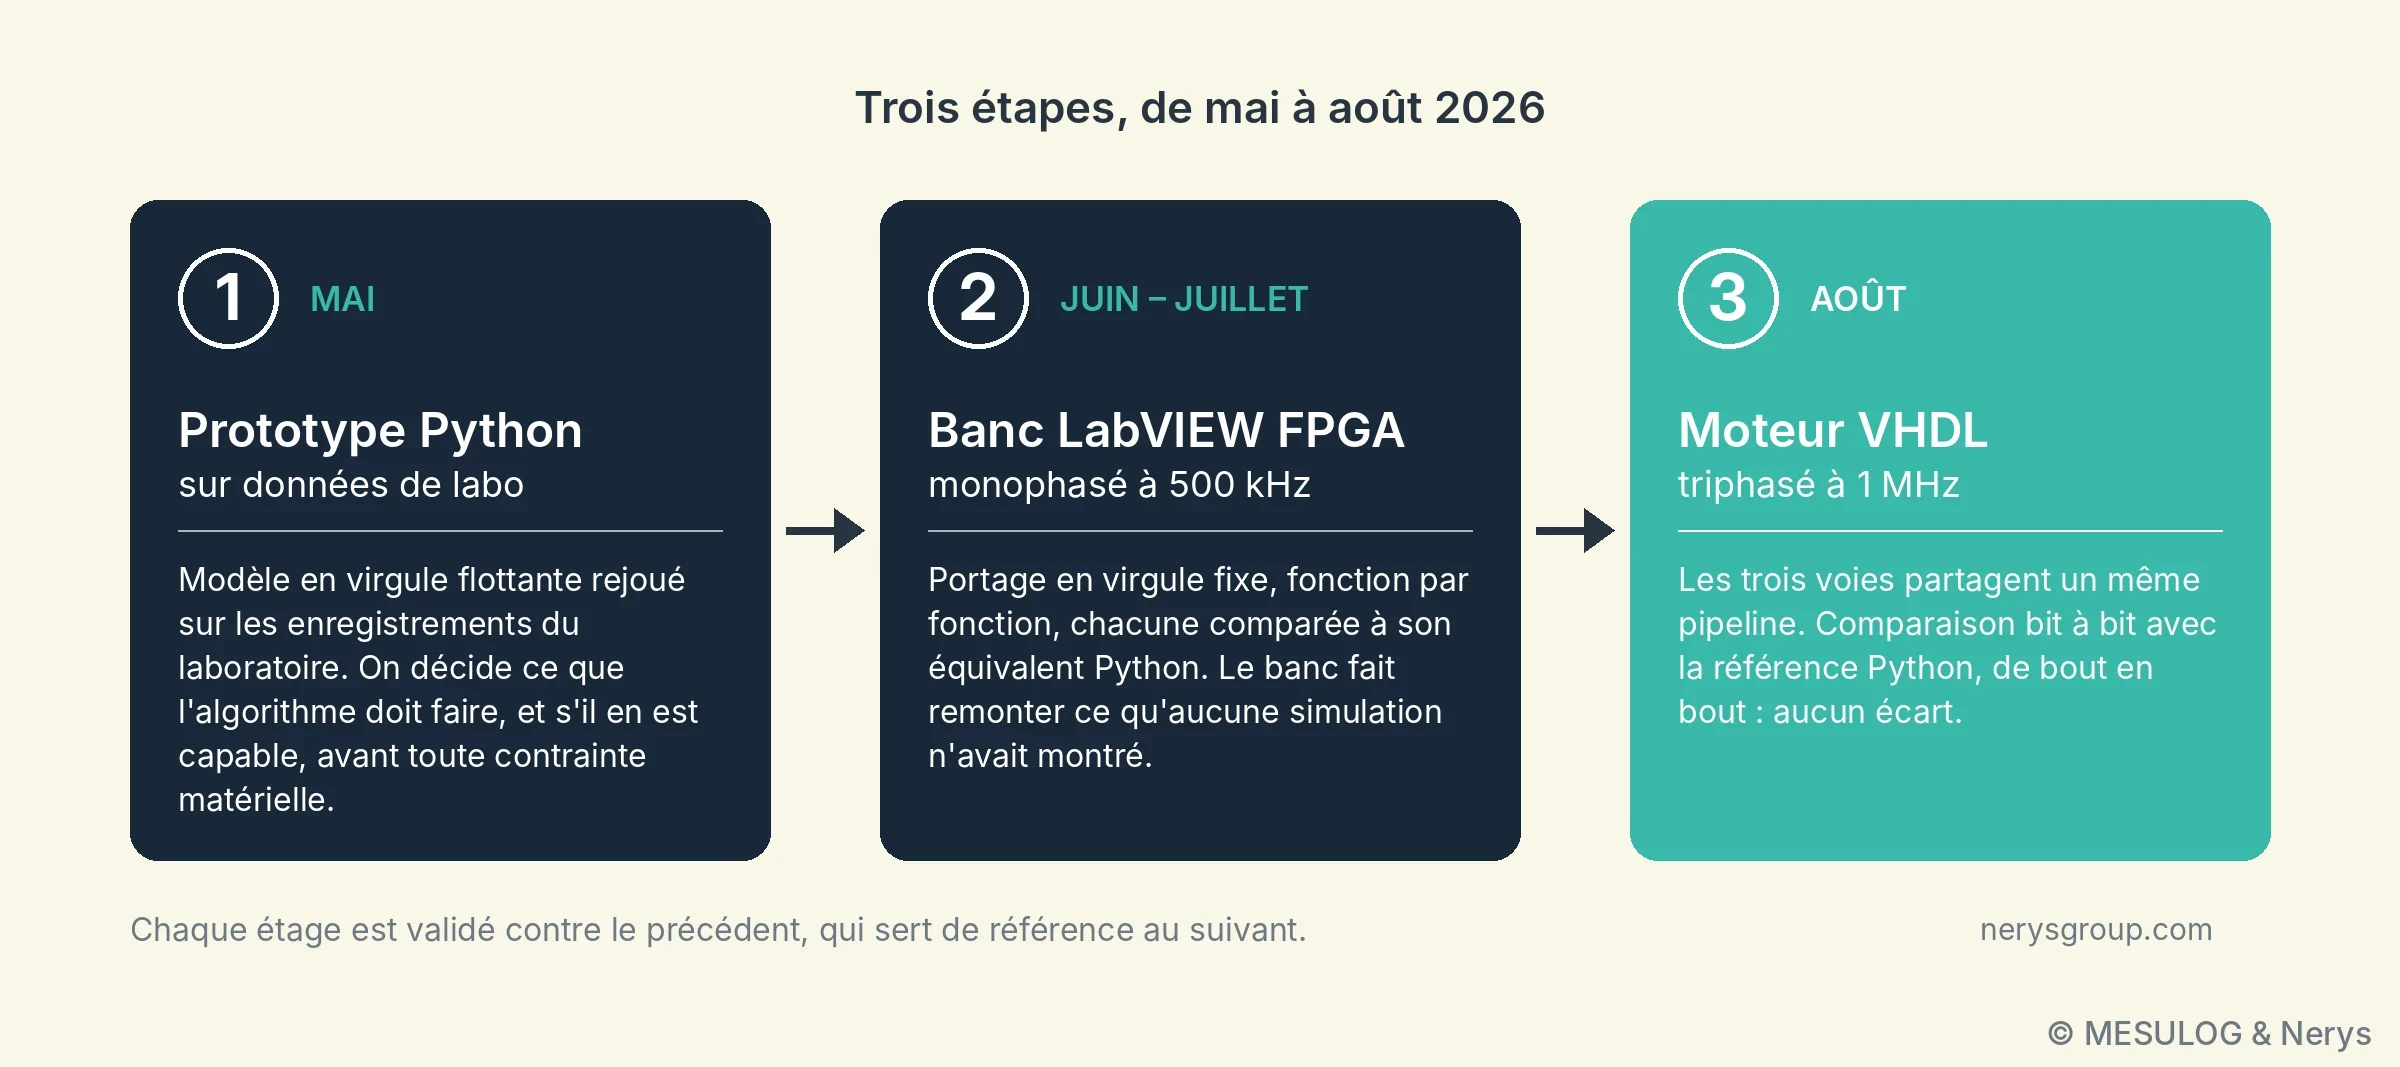
Trois étapes, de mai à août 2026. Les contraintes d'intégration, FPGA, 1 MHz, virgule fixe, n'offrent aucune souplesse pour concevoir un algorithme. Les ingénieurs ont donc séparé les problèmes. En mai, un prototype Python en virgule flottante, rejoué sur les enregistrements de référence du laboratoire : c'est là qu'on décide ce que l'algorithme doit faire et s'il en est capable, avant toute contrainte matérielle. En juin et juillet, un banc LabVIEW FPGA monophasé à 500 kHz : portage en virgule fixe, fonction par fonction, chacune comparée à son équivalent Python sur les mêmes vecteurs. En août, un moteur VHDL triphasé à 1 MHz, les trois voies partageant un même pipeline, comparé bit à bit contre la référence Python de bout en bout : aucun écart.
Le mot important de l'étape 2 est « banc ». Les essais sur données réelles ont fait remonter ce qu'aucune simulation n'avait montré : des rebonds de détection au voisinage du zéro, dus au bruit du convertisseur, et des formats de virgule fixe trop courts sur certains accumulateurs. C'est une information qui ne peut venir que du matériel, et les retours de l'équipe Schneider sur le comportement réel près du zéro ont réorienté plusieurs choix d'implémentation et de paramétrage. Et le zéro écart bit à bit de l'étape 3 n'est pas une formalité : c'est ce qui autorise à dire que le VHDL fait exactement ce que fait le prototype, ni plus ni moins.
Comment l'IA générative a été utilisée. C'est la partie qui a le plus étonné la salle, et c'est celle qu'il faut décrire précisément pour ne pas la survendre. L'IA n'a pas conçu l'algorithme. Elle a porté un algorithme conçu et validé en virgule flottante vers la virgule fixe, LabVIEW puis VHDL, écrit les bancs de test et leurs vecteurs en même temps que le code, et tenu la documentation à jour. Ce qui a rendu cela possible tient en trois idées.
La première : l'écart revient chiffré. Un harnais compare chaque implémentation à la référence, échantillon par échantillon, en microsecondes et en bits. Le retour n'est jamais « ça ne marche pas », mais « à l'échantillon 1247, cet état diverge de 3 LSB ». Le harnais produit un écart, pas un avis, et la correction qui suit est ciblée. La deuxième : ce qui a été compris une fois est écrit. Chaque piège trouvé, un décalage d'indice dans une récursion, un format trop court, part dans un fichier relu à chaque session ; on ne le repaie pas. La troisième : le plan passe avant le code. Les gros lots, comme la mutualisation des trois voies sur un seul moteur, sont spécifiés dans un document validé avant la première ligne. On ne corrige pas une direction après 2 000 lignes.
La condition de tout le reste, et ce qui a coûté le plus cher à construire : un modèle Python bit-exact de l'arithmétique en virgule fixe. Sans lui, la boucle n'a pas de capteur, et aucune itération n'est vérifiable. L'image donnée par Amaury Laurent est celle d'un asservissement : « l'IA produit, l'humain mesure l'écart et le renvoie ». Ce qui rend la boucle stable, c'est que l'écart est une mesure et non une appréciation, et que l'expertise humaine fixe le gain. Une boucle qui n'accroche pas, on l'arrête, et on repart d'un plan neuf plutôt que d'empiler les correctifs.
Ce qui est resté humain. Le savoir-faire. La spécification et le critère d'acceptation. La lecture physique d'un résultat, bruit de convertisseur ou vrai bug. Les arbitrages d'architecture, et l'abandon des pistes qui ne tenaient pas. Le banc, les données, et ce qui part chez le client. En trois mois, de l'ordre de dix mille lignes de VHDL, trois fois plus de modèle et de harnais Python, plus de vingt mille lignes de documentation et plus de deux cents itérations versionnées. Le facteur limitant n'a jamais été la vitesse d'écriture du code, mais celle de la vérification ; c'est là que l'outil a servi. Chaque modification était comparée à la référence en quelques minutes, là où un portage classique se vérifie par campagnes de simulation.
Où en est la précision. L'estimation s'affine en continu : plus la prédiction est émise tard, plus elle est juste. Sur les neuf voies des essais triphasés, l'erreur médiane sur l'instant du zéro vaut environ 50 µs quand la prédiction est émise 1 ms avant le zéro, 15 µs à 0,5 ms, 5 µs à 100 µs et 2 µs à 10 µs. Le compromis se négocie donc avec le temps de réponse de l'organe de coupure : plus il est lent, plus il faut décider tôt, et plus l'erreur est grande.
Avec le paramétrage actuel, la cible de moins de 10 µs est atteinte au plus près sur trois voies sur neuf, et cinq autres se situent entre 12 et 40 µs. Ces chiffres ne sont pas figés, et les intervenants ont préféré le dire tel quel plutôt que de présenter comme acquis un résultat qui ne l'est pas. Côté ressources, le moteur VHDL triphasé reste identique bit à bit à la référence Python, occupe 29 % des blocs DSP du FPGA Kintex-7 et consomme 22 des 40 cycles d'horloge disponibles pour chaque échantillon : il reste de la marge pour la suite.
6. Un fichier de mesures et une IA générative : ce qui marche, et ce qui ne marche pas
L'atelier avait commencé par une question à main levée : « qui a déjà demandé quelque chose à une IA sans trop savoir ce qu'il cherchait ? » Les mains s'étaient levées, avec des rires. Le dernier exemple y répondait.
Le plus quotidien des six : un fichier CSV de mesures en entrée, une IA générative, et une demande volontairement vague, « analyse-moi ça ». Le fichier de démonstration contient 200 pièces passées sur un banc de test électronique : horodatage, numéro de série, banc, opérateur, tensions 3,3 V et 5 V, courant de repos, fréquence d'horloge (25 MHz nominal), température, bruit RMS, durée du test, verdict et liste des mesures hors limites.
Le résultat est impressionnant. En quelques minutes : statistiques par colonne, histogrammes, répartition des échecs par opérateur et par banc, corrélations, et un classeur Excel mis en forme avec ses graphiques. C'est là que les équipes de Mesulog et de Nerys gagnent le plus de temps aujourd'hui, sans projet à six mois : l'analyse d'un journal d'erreurs, la mise en forme d'un rapport, le premier dégrossissage d'un fichier qu'on découvre.
Mais a-t-on obtenu l'information qui permet de décider ? Pas nécessairement. Un point de départ, oui ; une finalité d'analyse métier, non. « Cette fois, ça n'a pas vraiment marché, parce que nous ne savions pas ce que nous cherchions », ont reconnu les intervenants. Un système à qui on demande de trouver quelque chose trouvera toujours quelque chose : une corrélation entre un opérateur et le bruit RMS, par exemple, ou une tendance qui suit la température de la journée. Ce n'est pas parce qu'il y a 250 pompiers sur un incendie que tous les événements où l'on voit 250 pompiers sont des incendies. La corrélation est réelle, l'explication n'est pas dans le fichier, et c'est celui qui connaît le banc qui sait si elle a un sens.
La différence avec l'exemple 2 est là. Interroger WATS sur la chute du FPY la semaine dernière, c'est poser une question précise à des données structurées ; demander « analyse-moi ça », c'est déléguer la question elle-même. L'outil est le même, le résultat ne l'est pas.
Le retournement : un signal stable, qui valide ?
L'atelier s'est terminé sur une mesure. Un signal acquis chaque jour sur un banc, plat, propre, répétable d'un jour sur l'autre. Question à la salle, à main levée : « ce signal est stable, qui valide ? » Des mains se sont levées.
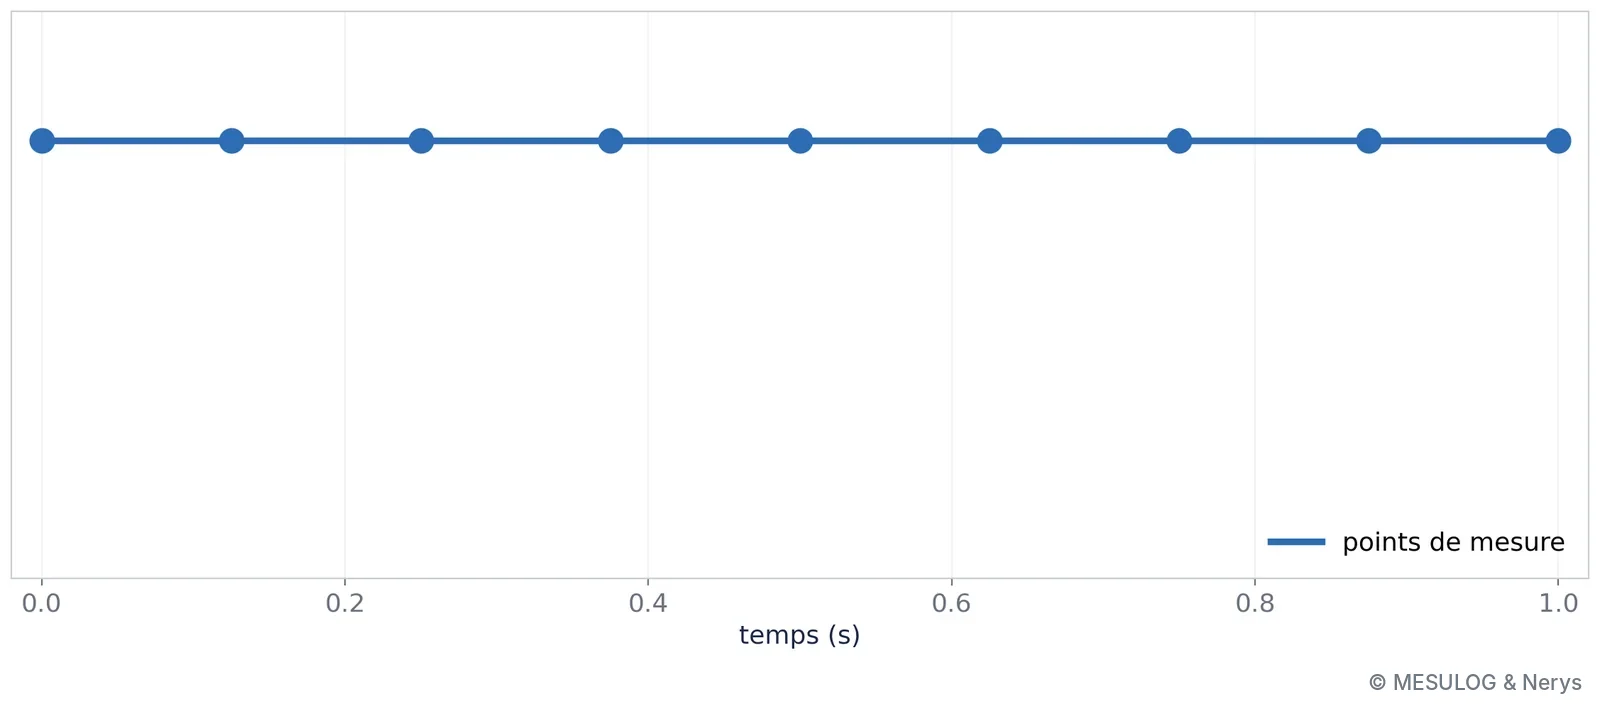
Puis le signal réel : une oscillation franche, échantillonnée à une fréquence malheureuse. Les points de mesure n'avaient pas bougé. Chaque échantillon tombait au même endroit de la période, si bien que l'oscillation entière disparaissait derrière une droite.
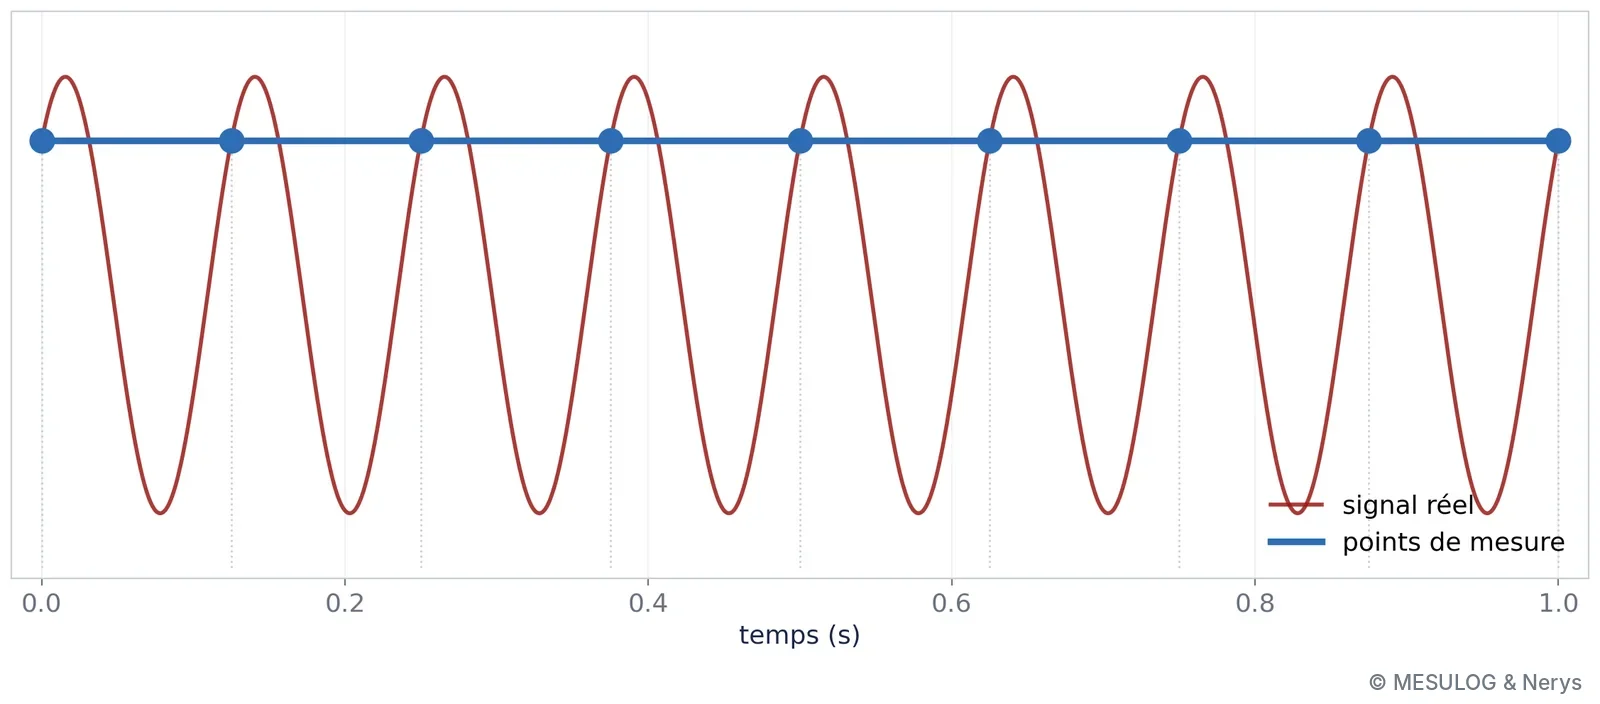
Ce n'est pas une erreur de mesure : l'instrument a répondu exactement à ce qu'on lui demandait. C'est du repliement de spectre. Le théorème d'échantillonnage le dit depuis Nyquist et Shannon : pour représenter un signal, il faut échantillonner à plus de deux fois sa fréquence la plus haute. En dessous, une oscillation rapide se replie en une fréquence plus basse, et dans le cas extrême d'un échantillonnage synchrone, en une constante. Aucun traitement en aval ne le rattrape : ni les statistiques, puisque l'écart-type est nul, ni un réseau convolutif, ni un modèle de langage. La parade est en amont : connaître la bande de fréquence du phénomène, choisir la fréquence d'échantillonnage en conséquence, et placer un filtre anti-repliement avant le convertisseur. Seule la connaissance du phénomène physique permettait de voir le piège, avant la mesure, pas après.
Qui décide ?
La conclusion de l'atelier tenait en un schéma : au centre, le responsable de la mesure ; autour, les pupitres, statistiques, classification, vision, génératif, et les protocoles qui branchent un modèle sur vos bancs et vos données. L'ingénieur n'est plus celui qui fabrique les outils : l'IA en a tant simplifié l'usage que chacun peut les utiliser. Il devient celui qui gère leur puissance, et il la pilote d'autant mieux qu'il la comprend. L'IA est un outil, extraordinaire de puissance, mais un outil.
Il n'y a pas d'un côté les statistiques et de l'autre l'IA. Il y a un continuum d'outils, et un ingénieur qui choisit le bon barreau de l'échelle.
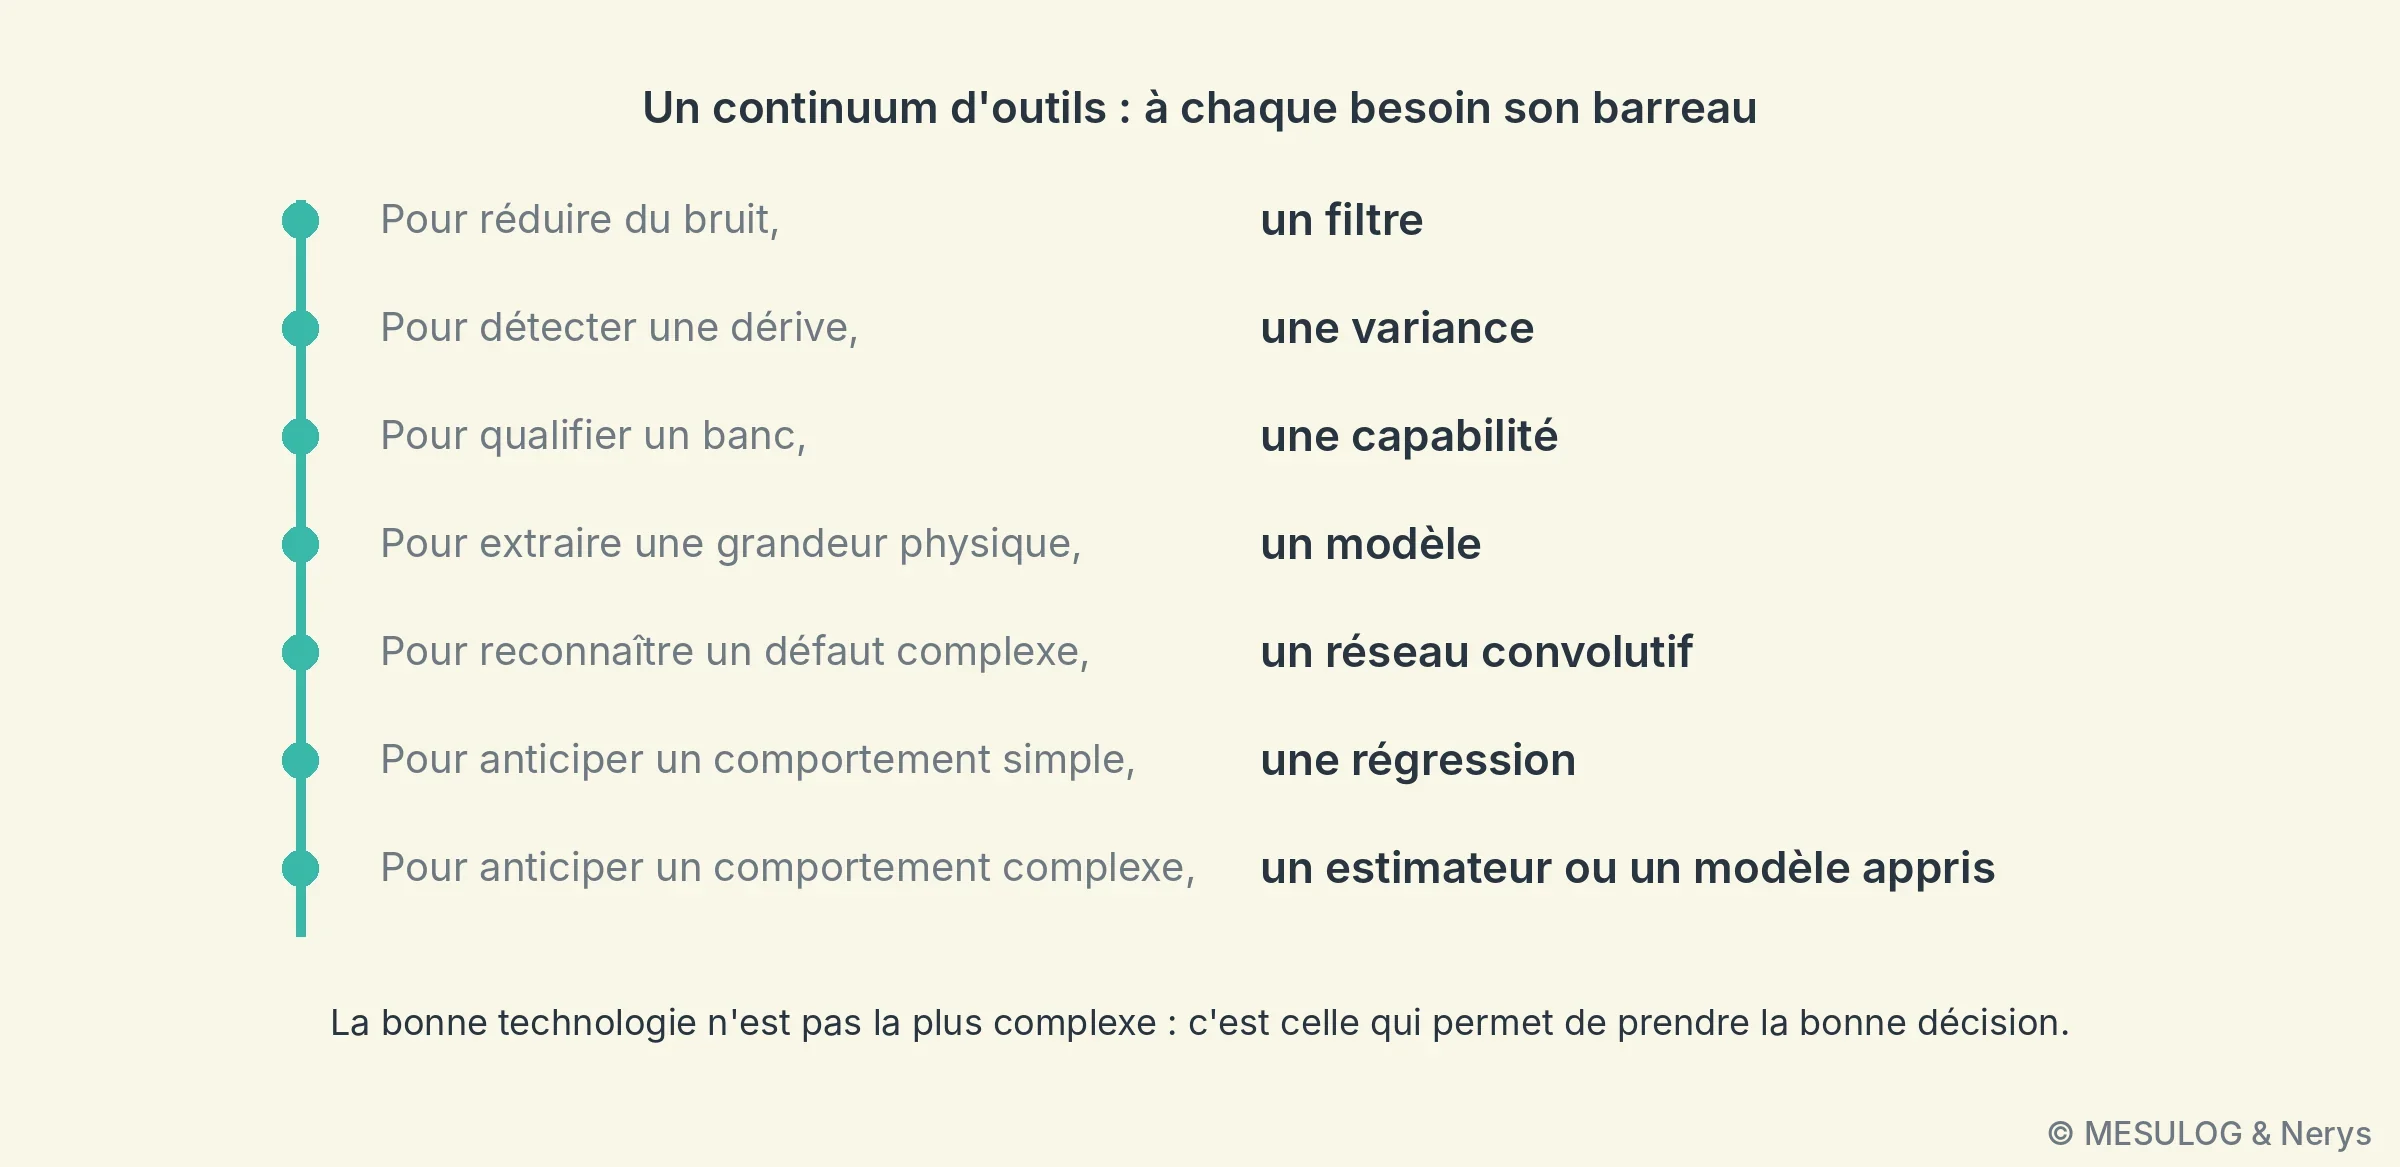
Pour réduire du bruit, un filtre, moyenne ou médiane selon la nature du bruit. Pour détecter une dérive, une variance ou une carte CUSUM. Pour qualifier un banc, une capabilité. Pour extraire une grandeur physique d'un nuage de points, un modèle géométrique. Pour reconnaître un défaut complexe, un réseau convolutif. Pour anticiper un comportement simple, une régression ; un comportement complexe, un estimateur ou un modèle appris. La bonne technologie n'est pas la plus complexe. C'est celle qui permet de prendre la bonne décision.
Une mesure dont vous ne savez pas quoi tirer, un signal à anticiper plutôt qu'à subir ? Les équipes de Nerys et de Mesulog en parlent volontiers : web@nerysgroup.com.


